Ki stimme klonen
Ki stimme klonen. KI-Stimme klonen leicht gemacht: Schritt-für-Schritt-Anleitung, rechtliche Hinweise zu EU-AI-Act und DSGVO sowie Tipps
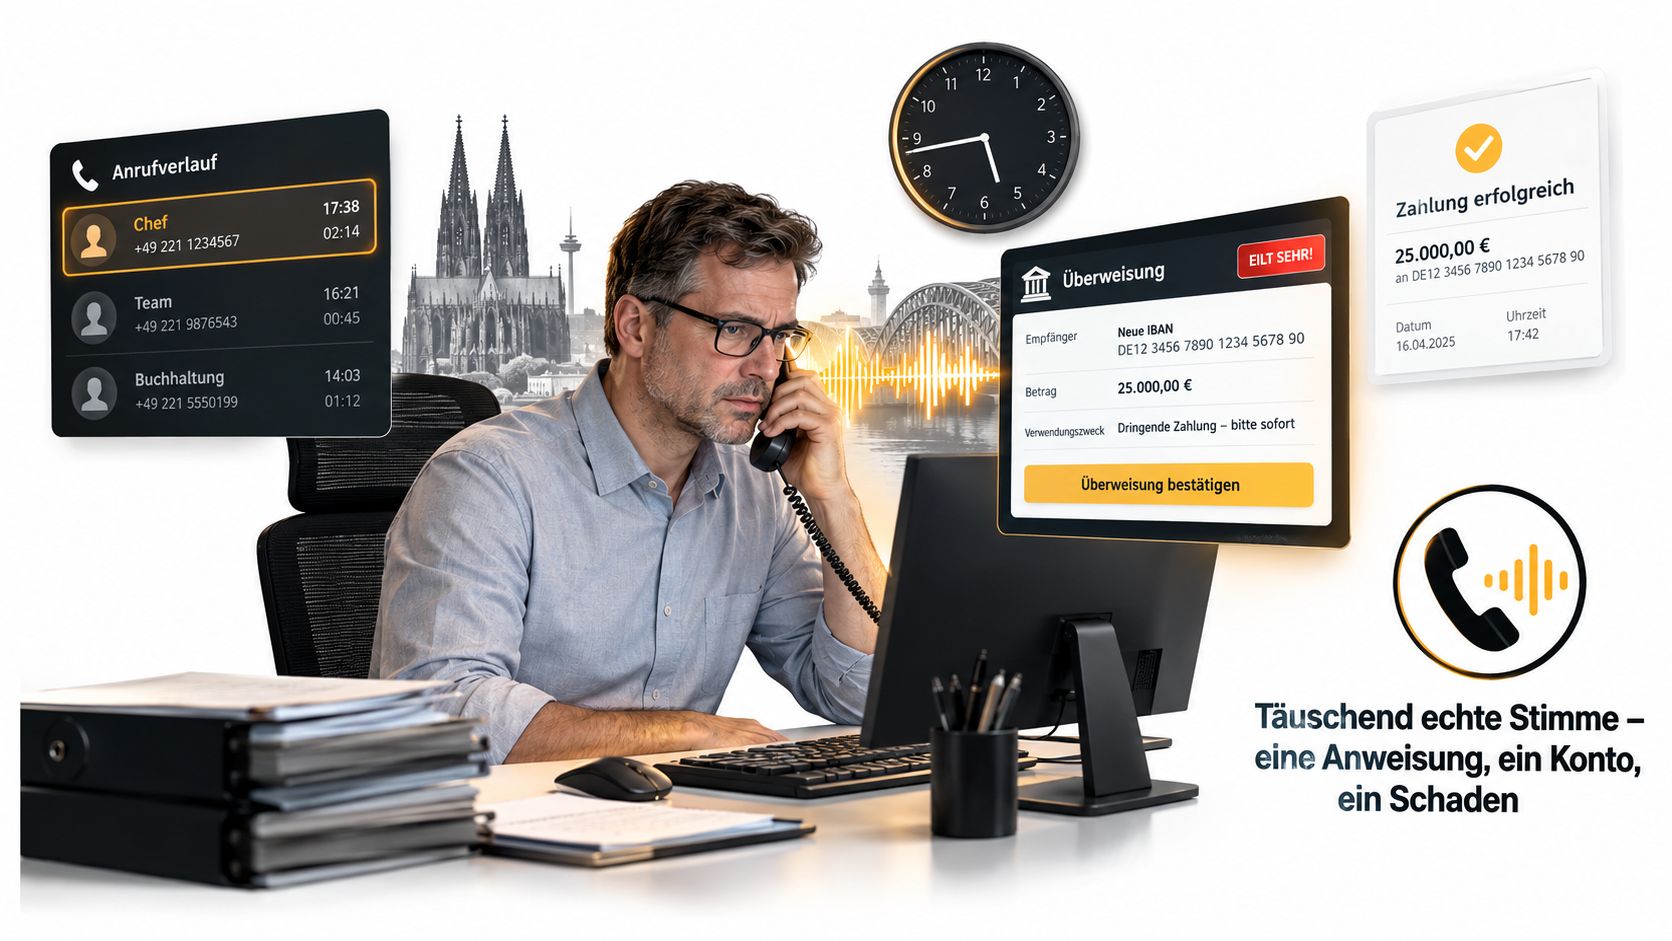
Am späten Nachmittag klingelt im Büro das Telefon. Die Stimme am anderen Ende klingt wie die des Geschäftsführers, kennt den Namen des Buchhalters und spricht über einen laufenden Vorgang. Es geht angeblich um eine dringende Überweisung auf ein neues Konto. Der Tonfall passt, der Zeitdruck wirkt plausibel, und wenige Minuten später ist das Geld unterwegs. Erst beim Rückruf über die bekannte Firmennummer fällt auf, dass der Geschäftsführer nie angerufen hat.
Genau deshalb sollten Unternehmen KI-Stimme klonen nicht nur als Produktionswerkzeug betrachten. Die Technik kann Voice-over, barrierefreie Inhalte und automatisierte Gespräche ermöglichen. Sie kann aber ebenso Vertrauen missbrauchen, Zahlungsprozesse umgehen und Mitarbeitende unter Druck setzen. Wer einen Klon sicher einsetzen will, muss deshalb den technischen Ablauf genauso gut verstehen wie Einwilligung, Kennzeichnung und interne Kontrollmechanismen.
Warum KI-Stimme klonen in Deutschland jetzt jeden betrifft
Ein geklonter Anruf muss nicht perfekt sein. Er muss nur lange genug glaubwürdig wirken, damit eine Person eine Information preisgibt, eine Zahlung vorbereitet oder eine Sicherheitsregel überspringt. Das macht Voice-Cloning für Social Engineering so gefährlich. Angreifer kombinieren die synthetische Stimme mit öffentlich zugänglichen Informationen, bekannten Namen und einem plausiblen Anlass.
In Deutschland ist dieses Risiko nicht mehr hypothetisch. Eine Erhebung zu KI-Stimmenklonings und Audio-Deepfake-Betrug mit rund 7.000 Befragten aus sieben Ländern, darunter etwas mehr als 1.000 Personen aus Deutschland, ergab, dass 22 Prozent der deutschen Teilnehmenden selbst oder im Umfeld bereits einen Audio-Betrug mit KI erlebt hatten. Dieselbe Erhebung beschreibt, dass KI-Software Stimmen mit bis zu 95 Prozent Genauigkeit klonen konnte.
Zwischen Betrug und sinnvoller Anwendung
Der technische Mechanismus ist zunächst neutral. Ein System extrahiert charakteristische Merkmale aus Sprachaufnahmen, bildet daraus ein Sprecherprofil und erzeugt anschließend neue Sprache aus Text. Die Qualität hängt dabei von Modell, Datenbasis, Aufnahmebedingungen und Nachbearbeitung ab. Je sauberer und variantenreicher das Material ist, desto weniger typische Artefakte bleiben übrig.
Seriöse Anwendungsfälle gibt es viele:
- Barrierefreiheit: Menschen können Inhalte mit einer freigegebenen, konsistenten Stimme zugänglich machen.
- Medienproduktion: Voice-over, Hörbuchpassagen und E-Learning lassen sich nach Textänderungen schneller anpassen.
- Service und Onboarding: Automatisierte Systeme können Informationen einheitlich und jederzeit ausgeben.
- Persönliche Stimmkonservierung: Wer mit einem späteren Stimmverlust rechnen muss, kann eine digitale Version vorbereiten.
Problematisch wird es, wenn die Stimme ohne klare Einwilligung eingesetzt wird oder eine synthetische Aussage wie eine echte persönliche Anweisung wirkt. Das EU-AI-Act-Zusammenfassung sollte deshalb nicht als abstraktes Rechtsthema gelesen werden, sondern als Hinweis auf konkrete Produktions- und Kontrollpflichten.
Warum der deutsche Markt besonders aufmerksam bleiben muss
Das Bundeskriminalamt erfasst KI-gestützte Betrugsfälle bisher nicht gesondert. Allein in Nordrhein-Westfalen wurden jedoch 2022 mehr als 8.000 Straftaten im Zusammenhang mit Schockanrufen und Enkeltricks registriert, wie die verlinkte Berichterstattung dokumentiert. Geklonte Stimmen erfinden dieses Betrugsfeld nicht neu. Sie machen eine bereits bekannte Täuschung glaubwürdiger.
Für KMU folgt daraus eine einfache Regel: Eine vertraute Stimme ist kein ausreichender Identitätsnachweis. Zahlungsanweisungen, Änderungen von Bankverbindungen und sensible Freigaben brauchen einen zweiten Kanal. Das gilt auch dann, wenn die Stimme vollständig natürlich klingt.
Vorbereitung bevor Sie eine KI-Stimme klonen
Die Qualität eines Klons entscheidet sich nicht erst beim Rendern. Sie beginnt bei den Rechten, der Aufnahme und der Frage, ob das Material den späteren Einsatz überhaupt abbildet. Schlechte Daten lassen sich durch ein besseres Modell nur begrenzt reparieren.
Rechte zuerst klären
Vor jeder Aufnahme sollte eine schriftliche, zweckgebundene Einwilligung vorliegen. Sie muss verständlich festhalten, wer die Stimme nutzen darf, für welche Anwendungen der Klon erzeugt wird, wo die Daten verarbeitet werden und wie lange sie gespeichert bleiben. Auch Widerruf, Löschung und die Beendigung der Nutzung gehören in die Vereinbarung.
Nehmen Sie keine Stimme aus einem Video, Podcast oder Telefonmitschnitt als Trainingsmaterial, nur weil sie öffentlich auffindbar ist. Öffentlich zugänglich bedeutet nicht automatisch zur Verarbeitung oder zum Klonen freigegeben. Bei Mitarbeitenden sollten Personalabteilung, Datenschutz und die verantwortliche Fachabteilung den Ablauf gemeinsam prüfen.
Aufnahme und Datensatz vorbereiten
Ein gutes Set braucht einen trockenen, ruhigen Raum, ein Popfilter und ein möglichst konstantes Mikrofon-Setup. WAV ist für die Bearbeitung geeigneter als verlustbehaftete Formate. Hall, wechselnde Mikrofonabstände, Hintergrundgespräche und automatische Sprachverbesserung erschweren die spätere Trennung der Stimme vom Raum.
Inhaltlich sollte das Material unterschiedliche Satzlängen, Fragesätze, Ausrufe, Zahlen, Eigennamen, Fremdwörter und verschiedene Sprechgeschwindigkeiten enthalten. Atempausen und Stille gehören nicht pauschal gelöscht. Sie liefern Informationen über Rhythmus und Natürlichkeit. Gleichzeitig müssen Versprecher, Nebengeräusche und Stimmen Dritter konsequent aussortiert werden.
Praktische Regel: Nehmen Sie nicht nur den perfekten Werbetext auf. Ein Klon, der ausschließlich glatt und langsam gesprochene Sätze kennt, klingt bei Rückfragen, Eigennamen und spontanen Betonungen schnell künstlich.
Teilen Sie das Material in ein Trainingsset und ein getrenntes Validierungsset. Mit dem zweiten Set prüfen Sie, ob der Klon wirklich allgemeine Eigenschaften der Stimme gelernt hat oder lediglich bekannte Aufnahmen nachbildet. Eine einheitliche Benennung der Dateien, normalisierte Lautstärke und dokumentierte Aufnahmebedingungen sparen später viel Fehlersuche.
| Qualitätsstufe | Aufnahmedauer | Audioformat | Einsatzgebiet |
|---|---|---|---|
| Standard | Kurzes, sauberes Referenzmaterial | WAV oder vergleichbar verlustarmes Format | Interne Tests und einfache Sprachentwürfe |
| Premium | Umfangreiches, variables Sprachmaterial | Unkomprimiertes WAV mit konstanter Aufnahmequalität | Voice-over, E-Learning und veröffentlichte Inhalte |
| Echtzeit | Bereinigtes Material mit klarer Aussprache und vielen Dialogvarianten | Für die Zielpipeline optimiertes WAV | Sprachagenten und interaktive Telefonie |
Wer Text direkt in Sprache umwandeln möchte, sollte den Klon nicht isoliert betrachten. Aussprache, Satzsegmentierung und die Struktur des Eingabetexts beeinflussen das Ergebnis ebenso. Die Grundlagen dazu lassen sich im Beitrag Text in Stimme umwandeln vertiefen.
So klonen Sie eine KI-Stimme Schritt für Schritt
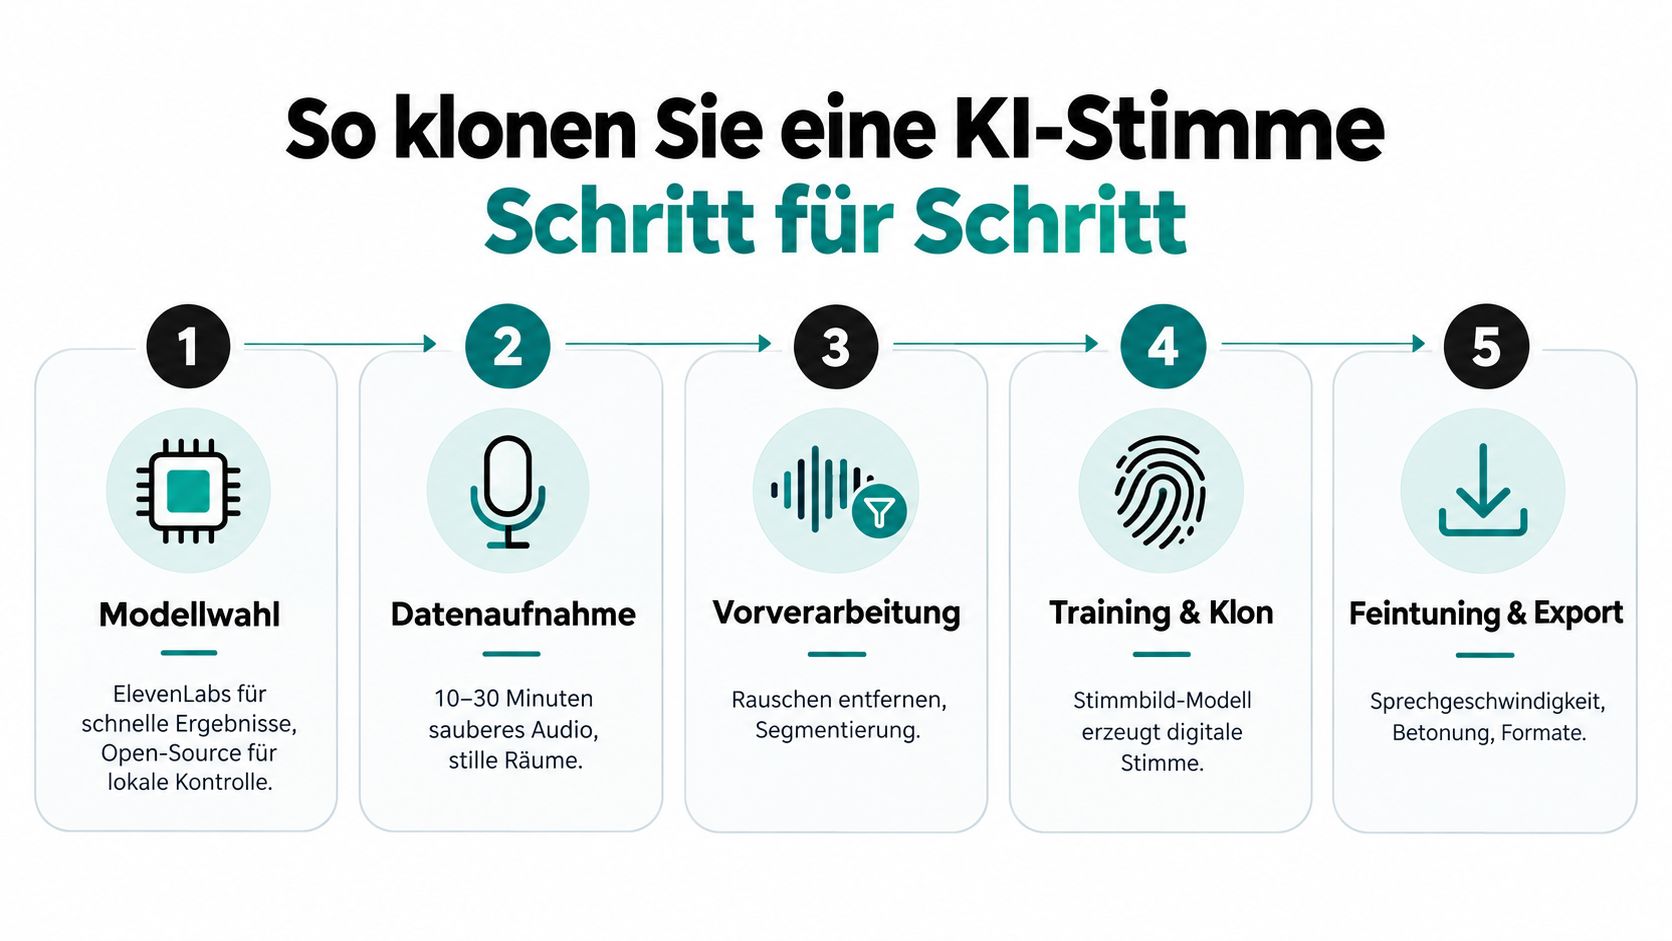
Beim praktischen Klonen geht es weniger um eine bestimmte Klickfolge als um eine Reihe nachvollziehbarer Entscheidungen. Ein schneller Cloud-Dienst, ein lokales Open-Source-Modell und ein Enterprise-System lösen dieselbe Aufgabe unter unterschiedlichen Bedingungen. Sie unterscheiden sich bei Kontrolle, Datenschutz, Latenz, Wartung und Kostenstruktur.
Modell passend zum Einsatz wählen
Für schnelle Ergebnisse in der Cloud kommen beispielsweise ElevenLabs, PlayHT oder Azure Neural TTS infrage. Diese Dienste reduzieren den Infrastrukturaufwand und bieten meist fertige Schnittstellen. Dafür müssen Unternehmen prüfen, wie Sprachproben gespeichert werden, in welcher Region die Verarbeitung stattfindet und welche Lösch- und Nutzungsregeln gelten.
Coqui XTTS, OpenVoice und RVC bieten mehr lokale Kontrolle. Das kann für sensible Sprachdaten, interne Forschung oder spezielle Anpassungen sinnvoll sein. Der Preis dafür ist technischer Aufwand. Teams müssen Abhängigkeiten, Modellversionen, GPU-Ressourcen, Sicherheitsupdates und reproduzierbare Deployments selbst organisieren.
Nach der Auswahl wird das bereinigte Material segmentiert und dem System zugeführt. Ein Speaker-Embedding beschreibt die charakteristischen Merkmale der Stimme in einer Form, die das Synthesemodell für neue Ausgaben verwenden kann. Bei einem lokalen Training kommen Lernrate, Batch-Größe, Epochenzahl und Regularisierung hinzu. Zu langes oder zu aggressives Training kann Overfitting verursachen. Dann klingt der Klon zwar bei bekannten Sätzen überzeugend, versagt aber bei neuem Text.
Aussprache kontrollieren und Ausgabe absichern
Die Eingabetexte sollten für die Stimme geschrieben sein, nicht nur für das Auge. Kurze Sätze, klare Interpunktion und kontrollierte Absätze helfen der Prosodie. Firmennamen, Produktbegriffe und Namen brauchen ein Custom-Lexikon. Bei anspruchsvollen Fachwörtern kann eine phonetische Schreibweise oder ein IPA-Eintrag die Aussprache stabilisieren.
Emotion, Tempo und Betonung sollten sparsam eingesetzt werden. Zu viele Steuerparameter erzeugen oft eine aufgesetzte Performance. Testen Sie stattdessen denselben Absatz mit mehreren Varianten und vergleichen Sie insbesondere Satzenden, Pausen und Übergänge zwischen Wörtern.
Die Ausgabe gehört in eine kontrollierte Pipeline. Verschlüsselte Downloads, rollenbasierte Zugriffe, Protokolle über Erzeugung und Freigabe sowie eine eindeutige Kennzeichnung gehören von Anfang an dazu. Dokumentieren Sie Modellversion, Datensatz, Einwilligung, Prompt, Nachbearbeitung und Veröffentlichungsziel. Diese Nachvollziehbarkeit ist nicht nur für Audits relevant. Sie zeigt auch, welche Änderung einen Fehler verursacht hat.
Qualität erkennen und natürlich klingen lassen
Ein Klon klingt selten überall gleich gut. In kurzen Werbesätzen kann er überzeugend wirken, während Zahlenfolgen, Eigennamen oder ein emotionaler Einwand die Schwächen offenlegen. Bei Tests sollten Sie deshalb nicht nur den Lieblingssatz anhören, sondern gezielt schwierige Passagen erzeugen.
Typische Warnzeichen sind ein gleichförmiger Atemrhythmus, fehlende Mikropausen, unnatürliche Sprünge bei Plosivlauten und ein metallischer Restklang bei Zischlauten. Auch eine übertriebene Gleichmäßigkeit der Tonhöhe verrät synthetische Sprache. Schlechte Audioqualität kann diese Merkmale überdecken oder selbst neue Artefakte erzeugen, deshalb sollten Original und Klon unter denselben Abhörbedingungen verglichen werden.
Drei Tests für die Praxis
Ein ABX-Vergleich eignet sich für die Identitätsprüfung. Spielen Sie eine Originalaufnahme, eine Ausgabe des Klons und anschließend zufällig eine der beiden Varianten ab. Die Testperson entscheidet, welche Datei erneut abgespielt wurde. Wichtig ist, dass das Sprachmaterial nicht aus dem Trainingsset stammt.
Ein Bewertungsbogen nach dem Prinzip des Mean Opinion Score kann die subjektive Beurteilung strukturieren. Bewerten Sie getrennt:
- Stimmähnlichkeit, klingt der Sprecher wie die Referenz?
- Aussprache, werden Namen, Zahlen und Fachwörter korrekt gesprochen?
- Prosodie, passen Rhythmus und Betonung zum Sinn?
- Natürlichkeit, wirken Pausen und Atembewegungen plausibel?
- Artefakte, treten Rauschen, Metallklang oder Übergangsfehler auf?
Für technische Kontrolle lässt sich die Grundfrequenzkurve in Praat untersuchen. Sie müssen daraus keine einzelne Kennzahl ableiten. Auffällige Sprünge, unplausibel glatte Verläufe oder identische Muster in vielen Sätzen zeigen, wo das Modell nachbearbeitet oder mit besserem Material neu trainiert werden sollte.
| Artefakt | Ursache | Maßnahme |
|---|---|---|
| Gleichförmige Betonung | Zu wenig prosodische Variation im Datensatz | Unterschiedliche Satztypen und Tonlagen aufnehmen |
| Metallischer Zischlaut | Modellfehler oder aggressive Rauschunterdrückung | Originalmaterial prüfen und Nachbearbeitung zurücknehmen |
| Falsche Eigennamen | Fehlendes Aussprachelexikon | Phonetische Schreibweisen und Custom-Lexikon pflegen |
| Abgehackte Pausen | Schlechte Segmentierung oder zu stark gekürzte Stille | Segmente neu schneiden und natürliche Atempausen erhalten |
| Unruhige Lautstärke | Uneinheitliche Aufnahmeabstände | Pegel angleichen und problematische Clips entfernen |
Nachbearbeitung in Audacity kann Pegel und störende Geräusche korrigieren, aber keine falsche Prosodie reparieren. Für Hörbücher gelten andere Prioritäten als für Telefonie. Bei einem Voice-Agenten sind Verständlichkeit, kurze Reaktionszeiten und stabile Aussprache oft wichtiger als eine besonders expressive Klangfarbe.
Rechtliche Pflichten beim Klonen einer KI-Stimme
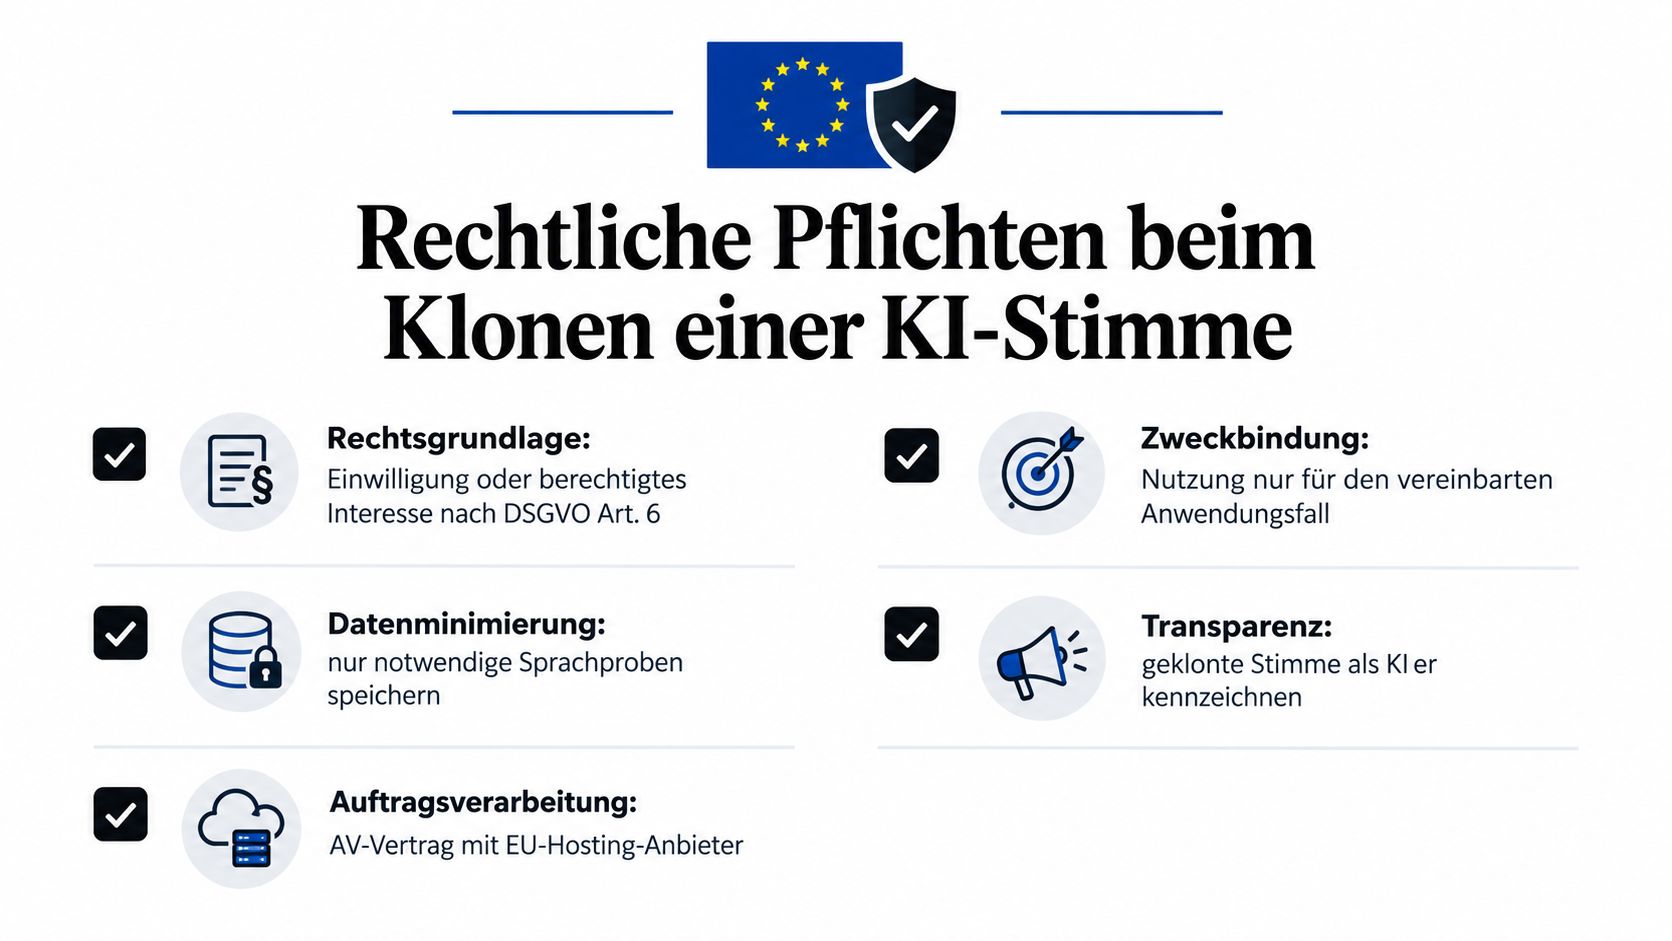
In Deutschland ist die Stimme nicht einfach ein beliebiger Audiodatensatz. Sie steht im Zusammenhang mit dem allgemeinen Persönlichkeitsrecht. Sprachproben können zugleich personenbezogene beziehungsweise biometrische Daten betreffen. Das Rechtsgutachten zu Stimmklonen und Persönlichkeitsrecht ordnet deshalb Einwilligung, Zweckbindung und kontrollierte Verarbeitung als zentrale Punkte ein.
Einwilligung und Zweckbindung
Eine belastbare Freigabe muss konkret sein. Sie sollte den Sprecher, den Zweck, die erlaubten Kanäle, die Dauer, die Datenverarbeitung und den Widerruf abdecken. Eine pauschale Klausel wie „Nutzung für digitale Medien“ lässt zu viele Fragen offen, wenn die Stimme später in Werbung, Telefonie und automatisierten Verkaufsgesprächen eingesetzt werden soll.
Verarbeiten Sie nur die Sprachdaten, die für den vereinbarten Zweck erforderlich sind. Speichern Sie Rohaufnahmen, bereinigte Dateien, Embeddings und fertige Modelle getrennt und mit klaren Zugriffsrechten. Ein Cloud-Anbieter braucht einen passenden Auftragsverarbeitungsvertrag. Bei einer Verarbeitung außerhalb der EU müssen zusätzlich die Regeln für internationale Datentransfers geprüft werden.
Auch der Aufnahmeort verdient Aufmerksamkeit. Werden Sprecher in Büros, Empfangsbereichen oder gemeinsam genutzten Räumen aufgenommen, sollten Unternehmen die Hinweise zu Privatsphäre in der Raumgestaltung berücksichtigen. Datenschutz beginnt nicht erst im Modell, sondern bereits dort, wo die Sprachprobe entsteht.
Transparenz in der Produktion
Für KI-generierte Audioinhalte verlangt die EU-KI-Verordnung ab dem 2. August 2026 eine maschinenlesbare Kennzeichnung, wie die verlinkte rechtliche Einordnung beschreibt. Unternehmen sollten Disclosure, Metadaten, Freigaben und Logging deshalb nicht erst kurz vor einem Rollout ergänzen. Die Produktionspipeline muss erkennen können, ob eine Ausgabe synthetisch ist und woher der verwendete Klon stammt.
Das betrifft auch interne Inhalte. Wenn ein automatisierter Anruf wie eine menschliche Person klingt, muss der Gesprächspartner angemessen informiert werden. Bei Marketing, Kundenservice und sensiblen Gesprächen sollte die Kennzeichnung nicht versteckt oder erst nachgelagert erfolgen.
Dokumentieren Sie nicht nur die Einwilligung. Halten Sie auch Modellversion, Datenherkunft, Anbieter, Hosting-Region, Freigabestatus und Löschzeitpunkt fest.
Eine Datenschutzerklärung für Voice-AI-Anwendungen ersetzt keine individuelle Prüfung. Sie kann aber helfen, Verarbeitungszwecke, Betroffenenrechte und technische Abläufe verständlich zu beschreiben. Bei fremden Stimmen, öffentlichen Personen, Werbung oder hohen Schadensrisiken gehört zusätzlich eine juristische Prüfung in den Freigabeprozess.
Schutz vor Missbrauch geklonter Stimmen im Unternehmen
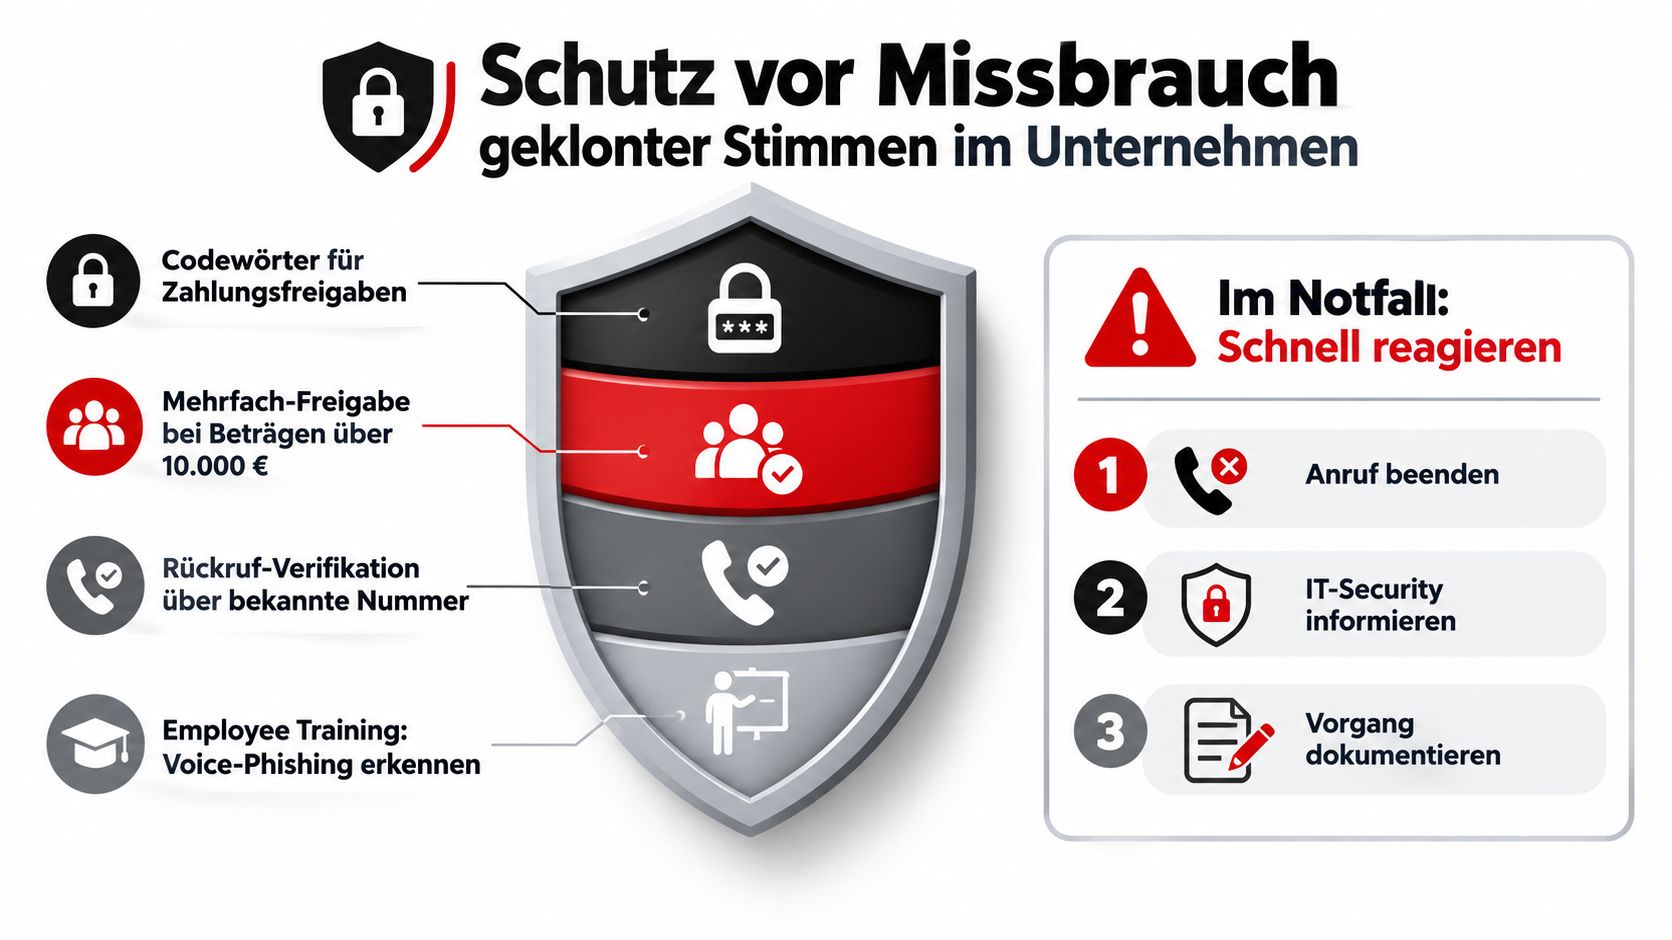
Eine Stimme darf in einem Unternehmen niemals alleinige Autorisierung für eine finanzielle oder sicherheitsrelevante Handlung sein. Das gilt unabhängig davon, ob der Anruf von einem Menschen, einem automatisierten System oder einem möglichen Stimmklon kommt.
Die deutsche Einordnung von KI-Betrug und Anrufbetrug zeigt die Lücke zwischen realer Verbreitung und offizieller Statistik. Für 2024 wurden 6.656 Fälle im Bereich Enkeltrick und Schockanruf gemeldet. Für 2025 wird in einer späteren Einordnung ein Schaden von rund 49 Millionen Euro bei knapp 4.800 gemeldeten Fällen genannt. Diese Zahlen beziehen sich auf das etablierte Betrugsfeld, nicht ausschließlich auf geklonte Stimmen. Gerade deshalb sollten KMU bestehende Zahlungs- und Identitätskontrollen jetzt auf Voice-Phishing erweitern.
Was im Alltag funktioniert
Ein Codewort kann in kleinen Teams eine zusätzliche Plausibilitätsprüfung schaffen. Es sollte nicht im Telefonbuch, im Chatverlauf oder in öffentlich zugänglichen Unterlagen stehen. Für größere Organisationen sind technische und organisatorische Verfahren wichtiger:
- Rückruf über bekannte Nummer: Beenden Sie den Anruf und wählen Sie die hinterlegte Nummer der betreffenden Person. Verwenden Sie nicht die Nummer aus dem eingehenden Gespräch.
- Mehrfache Freigabe: Zahlungen und Änderungen von Kontodaten brauchen eine zweite Person und einen unabhängigen Kanal.
- MFA-gesicherte Bestätigung: Freigaben sollten über das bestehende Identitätsmanagement erfolgen, nicht über eine mündliche Zusage.
- Voice-Authentifizierung mit Liveness-Prüfung: Solche Systeme können eine zusätzliche Schicht bilden, ersetzen aber keine Prozesskontrolle.
- Schulung mit realistischen Szenarien: Empfang, Assistenz, Finance und Geschäftsführung müssen Zeitdruck und Autoritätsmissbrauch erkennen.
Dedizierte Detection-Tools können bei aufgezeichneten Dateien helfen, sind im Live-Telefonat aber keine alleinige Lösung. Ein falsches Sicherheitsgefühl ist gefährlicher als ein klarer Rückrufprozess.
Sofort-Checkliste bei Verdacht
Beenden Sie den Anruf, ohne weitere Informationen zu bestätigen. Informieren Sie die zuständige Führungskraft, Finance und IT-Security über einen zweiten Kanal. Dokumentieren Sie Uhrzeit, Rufnummer, Wortlaut, Zahlungsziel, geforderte Handlung und vorhandene Aufzeichnungen. Wurde bereits überwiesen, müssen Bank, Geschäftsführung, Versicherung und gegebenenfalls Polizei ohne Verzögerung eingebunden werden.
Führen Sie Schulungen und simulierte Phishing-Anrufe zunächst dort durch, wo das finanzielle oder operative Risiko am größten ist. Ein KMU braucht nicht zwingend sofort ein umfassendes Detection-System. Es braucht zuerst klare Freigaben, bekannte Rückrufnummern, geübte Eskalationen und Mitarbeitende, die eine scheinbar vertraute Stimme unterbrechen dürfen.
Die nächsten Schritte für Ihr Voice-AI-Projekt
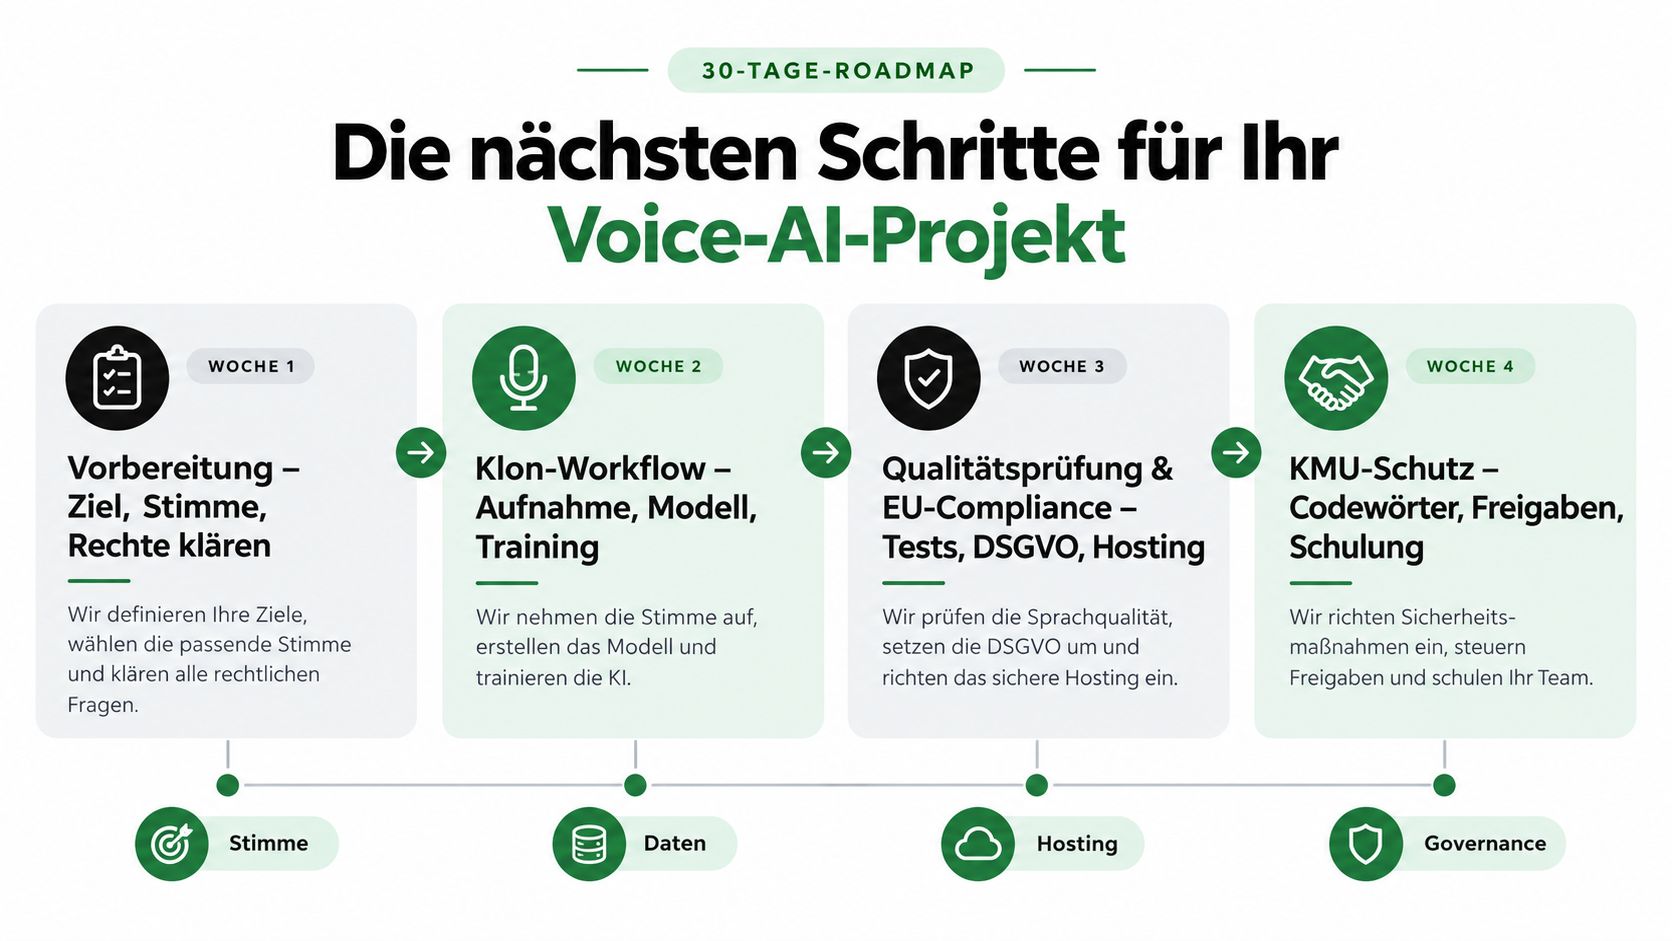
Ein Voice-AI-Projekt scheitert selten an der reinen Synthese. Es scheitert eher daran, dass Daten, Rechte, Hosting, Qualitätssicherung und interne Sicherheit getrennt geplant werden. Die folgenden vier Wochen verbinden diese Entscheidungen zu einem überprüfbaren Startpunkt.
Woche eins mit Ziel und Rechten beginnen
Definieren Sie einen einzigen Anwendungsfall. Das kann ein interner Voice-over-Prozess, ein barrierefreier Inhalt oder ein klar begrenzter Service-Dialog sein. Bestimmen Sie die Sprecherin oder den Sprecher, holen Sie die zweckgebundene Freigabe ein und legen Sie fest, wer später Zugriff auf Rohdaten und Modell erhält.
Das Ergebnis der ersten Woche ist kein fertiger Klon, sondern ein freigegebenes Projektdokument mit Zweck, Datenquelle, erlaubten Kanälen, Löschregeln und Verantwortlichen.
Woche zwei für Aufnahme und Modell reservieren
Erstellen Sie ein bereinigtes Referenzset mit unterschiedlichen Sprechsituationen. Vergleichen Sie einen Cloud-Dienst mit einer lokalen Option anhand von Datenschutz, Latenz, Wartung und Integrationsaufwand. Lassen Sie das Modell nur mit Material trainieren, dessen Herkunft dokumentiert ist.
Am Ende dieser Phase sollten eine reproduzierbare Datenablage, eine Modellversion und ein kleiner Testsatz vorliegen. Verwenden Sie für die Bewertung neue Sätze, nicht nur bekanntes Trainingsmaterial.
Woche drei auf Prüfung und Compliance konzentrieren
Testen Sie Aussprache, Pausen, Tonfall und Artefakte. Prüfen Sie, ob der Anbieter die vereinbarte Hosting-Region, Löschung und Zugriffskontrolle tatsächlich abbildet. Ergänzen Sie Kennzeichnung und maschinenlesbare Metadaten so, dass sie nicht von einzelnen Mitarbeitenden manuell erinnert werden müssen.
Stoppen Sie den Rollout, wenn die Einwilligung unklar ist, Drittstimmen im Datensatz auftauchen, das Modell nicht gelöscht werden kann oder niemand die erzeugten Dateien zurückverfolgen kann.
Woche vier mit Sicherheitsleitplanken abschließen
Definieren Sie Rückrufregeln, Freigaben für Zahlungen, Codewörter und einen Ansprechpartner für Voice-Incidents. Schulen Sie die Teams, die am ehesten unter Zeitdruck handeln müssen. Eine produktive Stimme ist erst dann bereit, wenn auch der Missbrauchsfall geübt wurde.
Für die Reifegradbewertung reichen drei Stufen:
- Pilot: Ein begrenzter Anwendungsfall, kontrollierte Nutzergruppe und manuelle Freigabe jeder Ausgabe.
- Produktiver Einsatz: Dokumentierte Rechte, getestete Qualität, sichere Zugriffe, Kennzeichnung und definierte Incident-Reaktion.
- Skalierung: Rollenmodell, automatisiertes Logging, regelmäßige Modelltests, Anbieterprüfung und wiederholte Mitarbeiterschulungen.
Für Unternehmen, die keine eigene Stimme klonen müssen, kann ein Voice-AI-Telefonagent mit ausgewählten, getesteten Stimmen der risikoärmere Einstieg sein. malma.ai nimmt eingehende Anrufe entgegen, qualifiziert Leads, bucht Termine und synchronisiert sich mit Kalender- und CRM-Systemen, ohne dass dafür ein unkontrollierter Stimmklon einer realen Person eingesetzt werden muss.
Wenn Sie ein Voice-AI-Projekt mit klaren Datenrechten, natürlicher Gesprächsführung und deutschen Sicherheitsprozessen aufsetzen möchten, prüfen Sie die verfügbaren Telefonagenten und Integrationen bei malma.ai. Starten Sie mit einem begrenzten Anwendungsfall, definieren Sie Rückruf- und Freigaberegeln und testen Sie die gesamte Kette von der Sprachaufnahme bis zur dokumentierten Kundeninteraktion.