Ki audio-zu text
Ki audio-zu text. KI Audio-zu-Text erklärt: Funktionsweise, Modelle, Qualität und DSGVO. Plus Integration in Voice-AI-Workflows für KMU und Servicebetriebe.
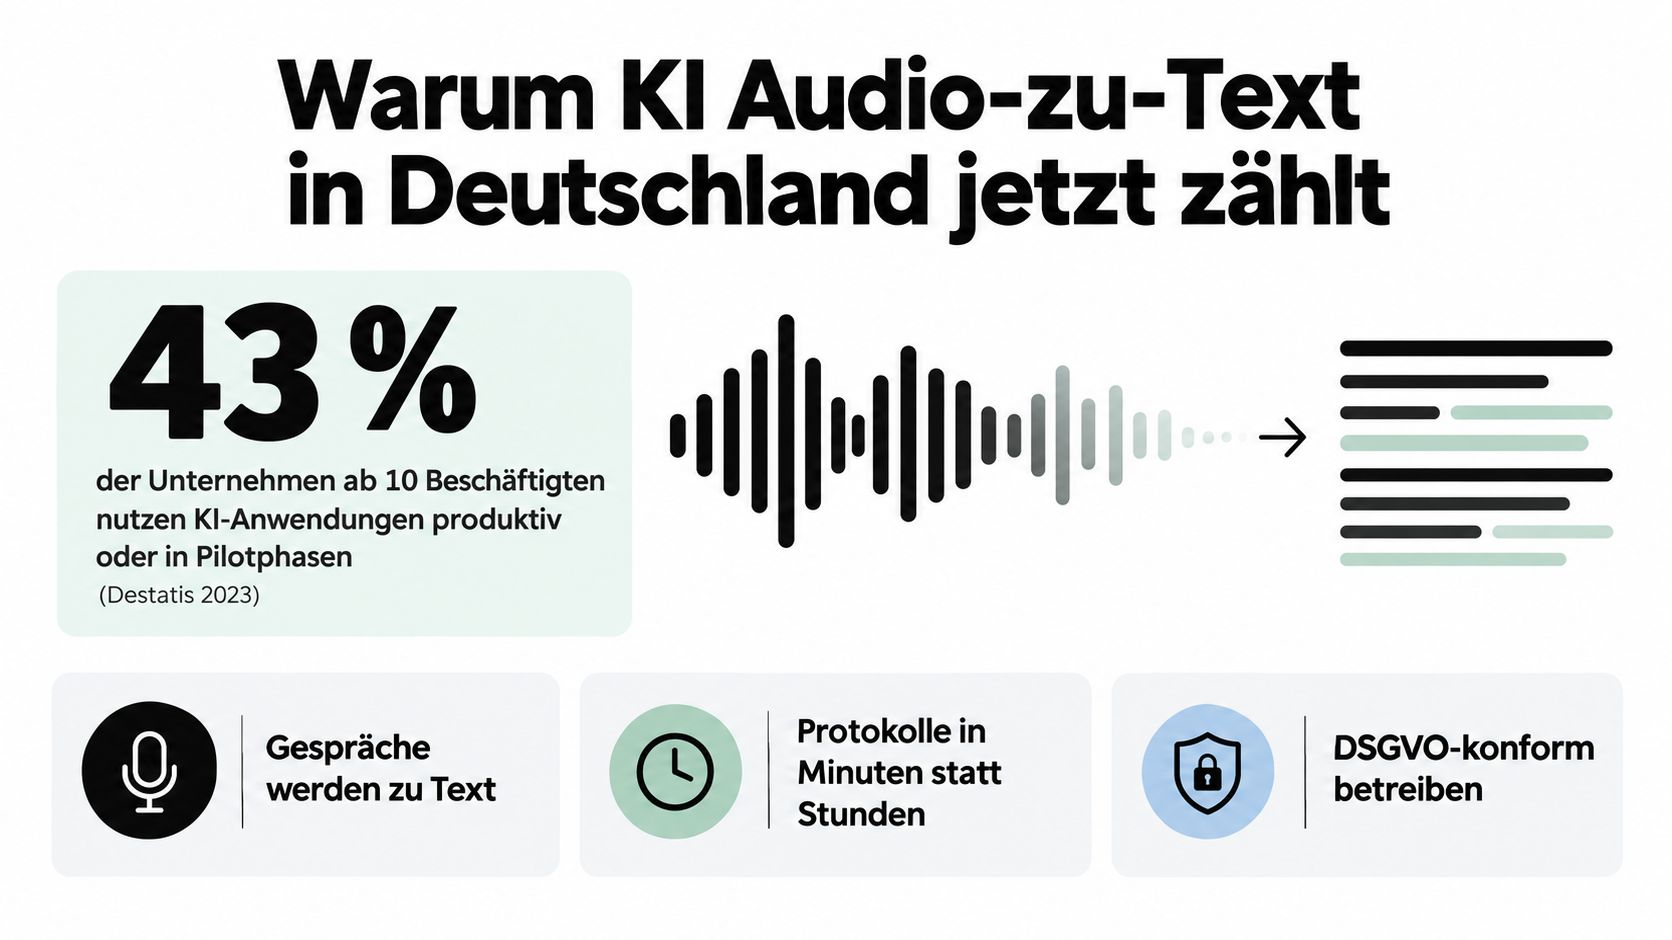
43 % der KI-nutzenden Unternehmen in Deutschland setzen bereits Spracherkennung ein. Das macht KI Audio-zu-Text zu mehr als einer technischen Spielerei: Gespräche, Diktate und Telefonate werden zu verwertbaren Informationen, die Unternehmen dokumentieren, durchsuchen und in ihre Abläufe übernehmen können. Die entscheidende Frage lautet deshalb nicht mehr, ob Sprache digital verarbeitet wird, sondern wie genau, wie schnell und unter welcher rechtlichen Grundlage.
Für Geschäftsführer ist dabei ein Punkt besonders wichtig: Ein Transkript ist kein neutraler Text. Es kann Namen, Telefonnummern, Gesundheitsinformationen, Vertragsinhalte, Passwörter oder vertrauliche Geschäftsdetails enthalten. Wer Audio-zu-Text sinnvoll einführen will, muss daher Technik, Qualität und Datenschutz gemeinsam betrachten.
Warum KI Audio-zu-Text in Deutschland jetzt zählt
Laut Destatis-Daten zur betrieblichen KI-Nutzung nutzten 2023 etwa jedes achte Unternehmen in Deutschland Künstliche Intelligenz. Unter den KI-nutzenden Unternehmen war Spracherkennung mit 43 % die am häufigsten eingesetzte KI-Technologie. Automatisierte Arbeitsabläufe beziehungsweise Entscheidungsunterstützung kamen auf 32 %, Text Mining auf 30 %.
Diese Zahlen verändern die Einordnung von Audio-zu-Text. Spracherkennung steht nicht mehr isoliert neben anderen KI-Funktionen, sondern bildet häufig die Eingangsschicht für weitere Prozesse. Ein Anruf wird transkribiert, daraus werden Anliegen und nächste Schritte erkannt, anschließend kann ein CRM-Eintrag entstehen oder ein Termin in den Kalender gelangen.
Sprache ist längst eine etablierte Schnittstelle
Die Akzeptanz begann nicht erst mit modernen generativen Modellen. Eine frühere deutsche Marktdokumentation bezog das Interesse an Spracherkennung und Sprachsteuerung auf eine hochgerechnete Bevölkerungsbasis von 70,33 Millionen Menschen im Jahr 2013, 70,52 Millionen im Jahr 2014 und 69,24 Millionen im Jahr 2015. Die Entwicklung zeigt, dass gesprochene Eingaben im digitalen Alltag schon vor der aktuellen KI-Welle eine breite Basis hatten. Die historische Einordnung des sprachbasierten NLP-Markts in Deutschland hilft deshalb, heutige Unternehmensanwendungen realistisch zu bewerten.
In der Praxis profitieren vor allem Organisationen mit vielen wiederkehrenden Gesprächen oder hohem Dokumentationsaufwand. Versicherungen können Gesprächsinhalte strukturieren, Kanzleien Diktate schneller in Text überführen, Arztpraxen Notizen vorbereiten und Handwerksbetriebe Anrufe für Rückruf, Terminplanung oder Angebotsanfragen auswerten.
Der Nutzen endet nicht beim Transkript
Ein reiner Volltext ist nur der erste Schritt. Der wirtschaftliche Wert entsteht, wenn das System Sprecher trennt, Fachbegriffe erkennt, Kernaussagen zusammenfasst und strukturierte Felder ausgibt. Gleichzeitig bleiben Dialekte, Nebengeräusche, Unterbrechungen und Fachvokabular anspruchsvoll.
Praktische Regel: Kaufen Sie keine Transkriptionslösung nur anhand einer Demo. Testen Sie sie mit echten, anonymisierten Aufnahmen aus Ihrem eigenen Arbeitsalltag.
Damit diese Entscheidung gelingt, sollten Verantwortliche verstehen, was zwischen Mikrofon und fertigem Text tatsächlich passiert.
So wandelt KI Audio in Text um
Eine Audio-zu-Text-Anwendung arbeitet meist als Pipeline mit fünf Stufen. Die einfachste Analogie ist ein Dolmetscher mit Notizblock: Er hört zunächst genau zu, hält sprachliche Muster fest, ordnet sie einer Sprache zu und formuliert daraus am Ende lesbare Sätze.
1. Audioaufnahme und Vorverarbeitung
Das System nimmt ein Mikrofonsignal auf und bereitet es für die Analyse auf. Bei Telefonie ist 16 kHz in Mono ein verbreitetes Format. Rauschfilter reduzieren Störgeräusche, während Voice Activity Detection erkennt, wann tatsächlich gesprochen wird. Dadurch verarbeitet die Anwendung nicht jede Pause und jedes Hintergrundgeräusch als mögliche Sprache.
2. Feature-Extraktion
Die rohe Wellenform ist für ein Modell schwer direkt zu interpretieren. Deshalb wird sie in Merkmale umgewandelt, etwa über ein Mel-Spektrogramm oder MFCCs. Diese Darstellung macht sichtbar, wie sich Frequenzen im Zeitverlauf verändern. Vereinfacht gesagt entsteht aus dem Schall eine mathematische Skizze, in der Sprachmuster besser vergleichbar sind.
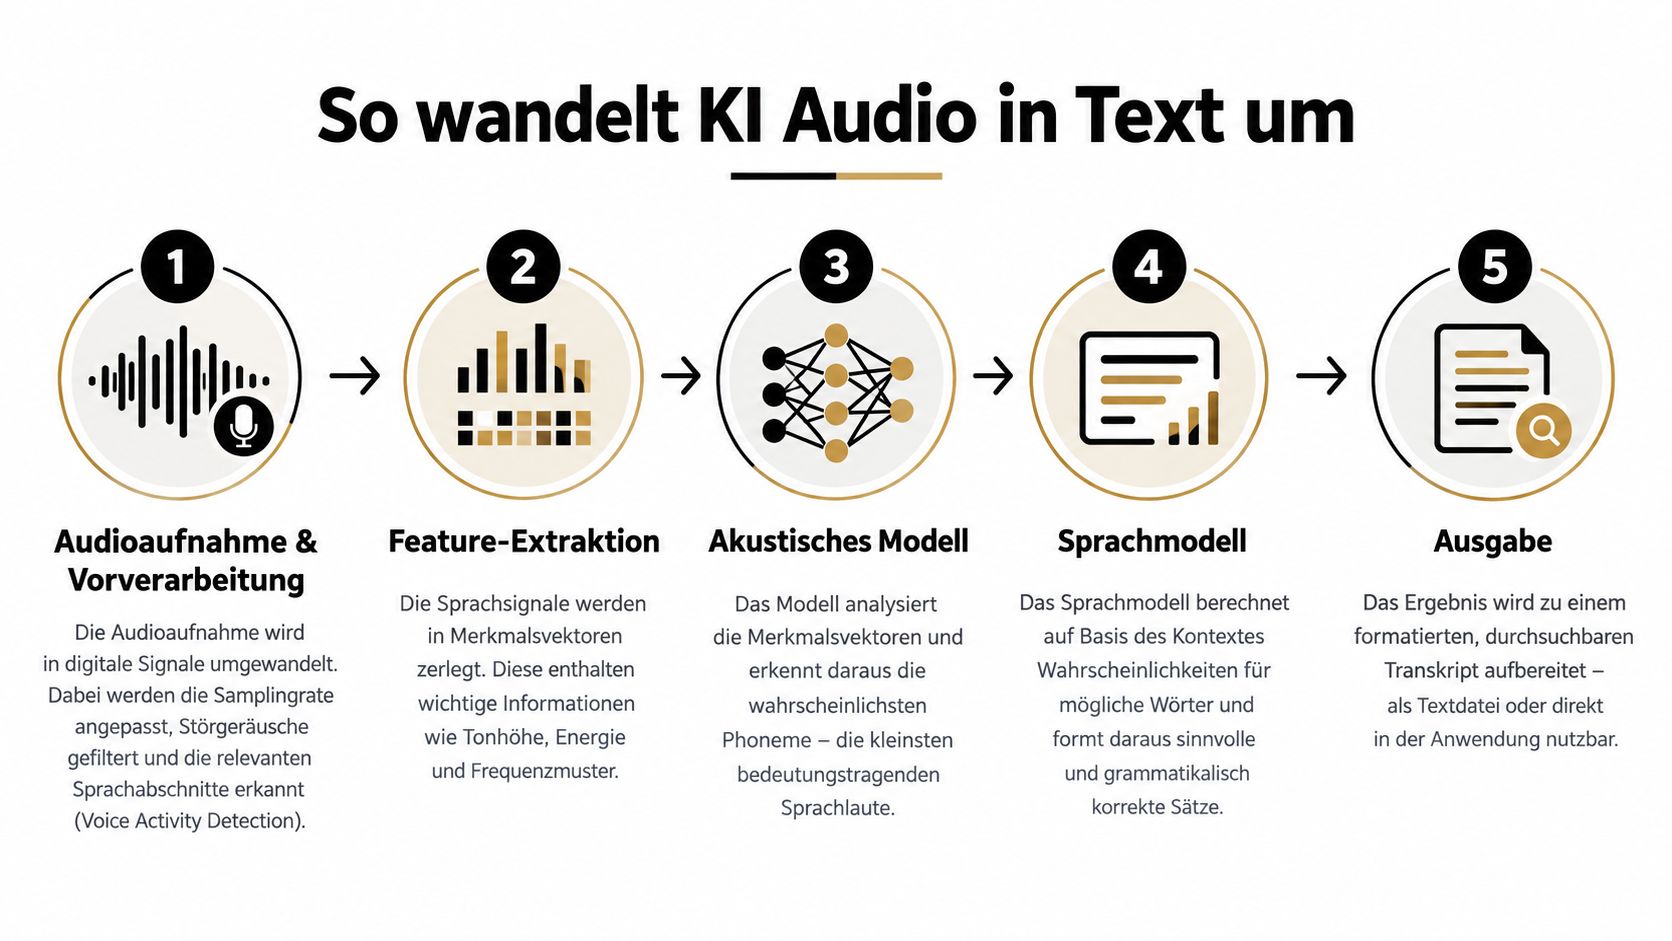
3. Akustisches Modell
Das akustische Modell verbindet die Merkmale mit Lauten und Sprachmustern. Architekturen wie Whisper oder Conformer verarbeiten dabei unterschiedliche zeitliche Zusammenhänge. Klassische Verfahren können mit CTC arbeiten, während aufmerksamkeitsbasierte Modelle den Kontext ganzer Äußerungen stärker berücksichtigen.
4. Sprachmodell-Decoding
Nun muss das System aus mehreren möglichen Lautfolgen sinnvolle Wörter bilden. Verfahren wie Beam Search vergleichen Kandidaten, N-best-Listen halten mehrere mögliche Ergebnisse vor, und ein Sprachmodell kann diese anschließend neu bewerten. Dadurch wird aus einer phonetisch plausiblen Folge ein Satz, der grammatisch und inhaltlich wahrscheinlicher ist.
5. Nachbearbeitung
Zum Schluss ergänzt die Anwendung Satzzeichen, normalisiert Zahlen und kann Sprecherlabels vergeben. Ein benutzerdefiniertes Vokabular hilft bei Produktnamen, medizinischen Begriffen oder internen Abkürzungen. Wer die technischen Grundlagen vertiefen möchte, findet eine verständliche Einführung in Speech Recognition und seine Funktionsweise.
Bei Echtzeitgesprächen läuft das Decoding fortlaufend in kleinen Audioabschnitten. Bei Batch-Verarbeitung wartet das System dagegen auf eine längere oder vollständige Aufnahme und kann dadurch mehr Kontext berücksichtigen. Diese Pipeline bleibt die Grundlage, auch wenn Anbieter unterschiedliche Modelle und Bereitstellungsformen verwenden.
Modelle und Architekturen im Überblick
Die passende Architektur hängt nicht allein von der Erkennungsqualität ab. Ein Unternehmen muss gleichzeitig Latenz, Datenhoheit, Integrationsaufwand und Auslastung bewerten. Eine Cloud-API ist schnell verfügbar und lässt sich meist unkompliziert in bestehende Anwendungen einbinden. On-Premise-Modelle geben der Organisation mehr Kontrolle über Daten und Betrieb, erfordern aber eigene Infrastruktur, Wartung und Kompetenz.
Bei Cloud-Diensten kommen je nach Anbieter unterschiedliche Modelle zum Einsatz, etwa OpenAI Whisper, Google Chirp oder Azure Speech. Für sensible Gespräche ist entscheidend, wo Audiodaten und Transkripte verarbeitet werden und welche Unterauftragnehmer beteiligt sind. Ein Serverstandort in Deutschland kann die Prüfung erleichtern, ersetzt aber keine vollständige Datenschutzbewertung.
On-Premise-Varianten wie Whisper-large-v3, NVIDIA Riva oder Kaldi-basierte Pipelines können innerhalb der eigenen Umgebung betrieben werden. Dafür braucht das Unternehmen passende Rechenkapazität, häufig mit geeigneten NVIDIA-GPUs. Der Aufwand lohnt sich eher, wenn Sprachdaten dauerhaft unter eigener Kontrolle bleiben müssen oder ein hohes Verarbeitungsvolumen entsteht.
Vier Entscheidungen, die oft verwechselt werden
Automatische Transkription eignet sich für aufgezeichnete Gespräche und Dokumente. Echtzeit-Transkription liefert Text während des Gesprächs und unterstützt Live-Untertitel, Agentenassistenz oder unmittelbare Gesprächssteuerung. Streaming verarbeitet fortlaufende Audioabschnitte, Batch-Verarbeitung analysiert eine fertige Datei und kann den vollständigen Kontext nutzen.
Auch die Modellbreite ist wichtig. Ein General-Purpose-Modell deckt viele Themen ab, kann aber bei Kanzlei-, Medizin- oder Industriesprache an Grenzen kommen. Ein domänenspezifisches Modell oder ein angepasstes Vokabular fokussiert sich stärker auf den jeweiligen Wortschatz.
| Architektur | Latenz | Typischer WER (DE) | DSGVO-Hosting | Kostenindikator |
|---|---|---|---|---|
| Cloud-API, Batch | Nach Verarbeitung | Anbieterabhängig | Vom Vertrag und Standort abhängig | Nutzungsabhängig |
| Cloud-API, Streaming | Nahezu live | Anbieterabhängig | Vom Vertrag und Standort abhängig | Nutzungsabhängig |
| On-Premise, Batch | Nach Verarbeitung | Abhängig von Modell und Anpassung | Eigene Umgebung | Infrastruktur und Betrieb |
| On-Premise, Streaming | Nahezu live | Abhängig von Modell und Hardware | Eigene Umgebung | Infrastruktur, Betrieb und GPU |
| Domänenspezifische Pipeline | Unterschiedlich | Stark vom Fachvokabular abhängig | Nach Bereitstellung | Anpassungs- und Betriebskosten |
Deutschsprachiges Feintuning ist beispielsweise bei spezialisierten Anbietern wie besser.ai und audEERING ein möglicher Ansatz. Letztlich entscheidet das Einsatzprofil: Telefonie braucht geringe Verzögerung, eine Rechtskanzlei braucht kontrollierte Datenverarbeitung, und ein Archiv profitiert von stabiler Batch-Verarbeitung.
Qualität von Transkription messen und vergleichen
Eine Transkription kann flüssig lesbar wirken und trotzdem für einen bestimmten Prozess ungeeignet sein. Deshalb sollten Teams Qualität nicht nur subjektiv beurteilen, sondern mit passenden Kennzahlen und realen Testaufnahmen prüfen.
WER und CER
Die Word Error Rate, kurz WER, vergleicht das maschinelle Ergebnis mit einem Referenztext. Sie erfasst ausgelassene, vertauschte und zusätzlich eingefügte Wörter. Die Character Error Rate, kurz CER, arbeitet auf Zeichenebene und kann bei Eigennamen, Abkürzungen oder deutschen Komposita zusätzliche Hinweise liefern.
Deutsch bringt besondere Herausforderungen mit. Lange zusammengesetzte Wörter, regionale Aussprache, Fachbegriffe und unterschiedliche Schreibweisen können die Bewertung verzerren. Ein niedriger WER allein garantiert deshalb nicht, dass ein Transkript für die Rechnungsprüfung, medizinische Dokumentation oder automatische Lead-Qualifizierung geeignet ist.
Latenz und Sprechertrennung
Latenz beschreibt die Zeit zwischen dem gesprochenen Wort und seiner Anzeige. Bei einem Meeting-Protokoll darf die Verarbeitung im Hintergrund laufen. Bei einem Live-Agenten oder einer Gesprächsassistenz stören lange Verzögerungen dagegen den Dialog und können Folgeaktionen ausbremsen.
Speaker Diarization ordnet Textabschnitte den jeweiligen Sprechern zu. Für ein Diktat mit nur einer Stimme ist sie nebensächlich. In einem Verkaufsgespräch oder Teammeeting entscheidet sie dagegen darüber, ob das Ergebnis direkt als Protokoll verwendet werden kann.
Nicht jede Abweichung ist gleich kritisch. Ein falsch gesetztes Komma kann belanglos sein, ein falsch erkannter Medikamentenname oder Betrag kann den gesamten Prozess unbrauchbar machen.
Die Zielwerte sollten aus dem konkreten Risiko abgeleitet werden. Ein Telefoniesystem kann mit einzelnen Erkennungsfehlern arbeiten, wenn es die Absicht des Anrufers korrekt erkennt. Ein Diktat für juristische oder medizinische Texte braucht dagegen eine sorgfältige Kontrolle. Bei Besprechungen zählen neben WER vor allem Sprechertrennung, Satzzeichen und die Erkennung von Namen und Aufgaben.
| Szenario | Ziel-WER | Latenz | Diarization |
|---|---|---|---|
| Telefonie und Anliegen-Erkennung | Niedrig genug für robuste Intent-Erkennung | Möglichst live | Hilfreich, aber nicht immer erforderlich |
| Diktat | Sehr niedrig, Fachvokabular entscheidend | Kurz bis nachgelagert | Meist nicht erforderlich |
| Meeting-Protokoll | Niedrig mit guter Lesbarkeit | Nachgelagert möglich | Wichtig |
| Live-Untertitel | Niedrig bei stabiler Ausgabe | Sehr kurz | Je nach Veranstaltung relevant |
Testen Sie nie nur im ruhigen Büro. Nutzen Sie Aufnahmen mit Telefonqualität, Hintergrundgeräuschen, Unterbrechungen, Dialekten und typischen Fachbegriffen. Erst der Vergleich mit einem manuell geprüften Referenztext zeigt, ob ein Modell für Ihren Prozess taugt.
Datenschutz und DSGVO bei Transkription
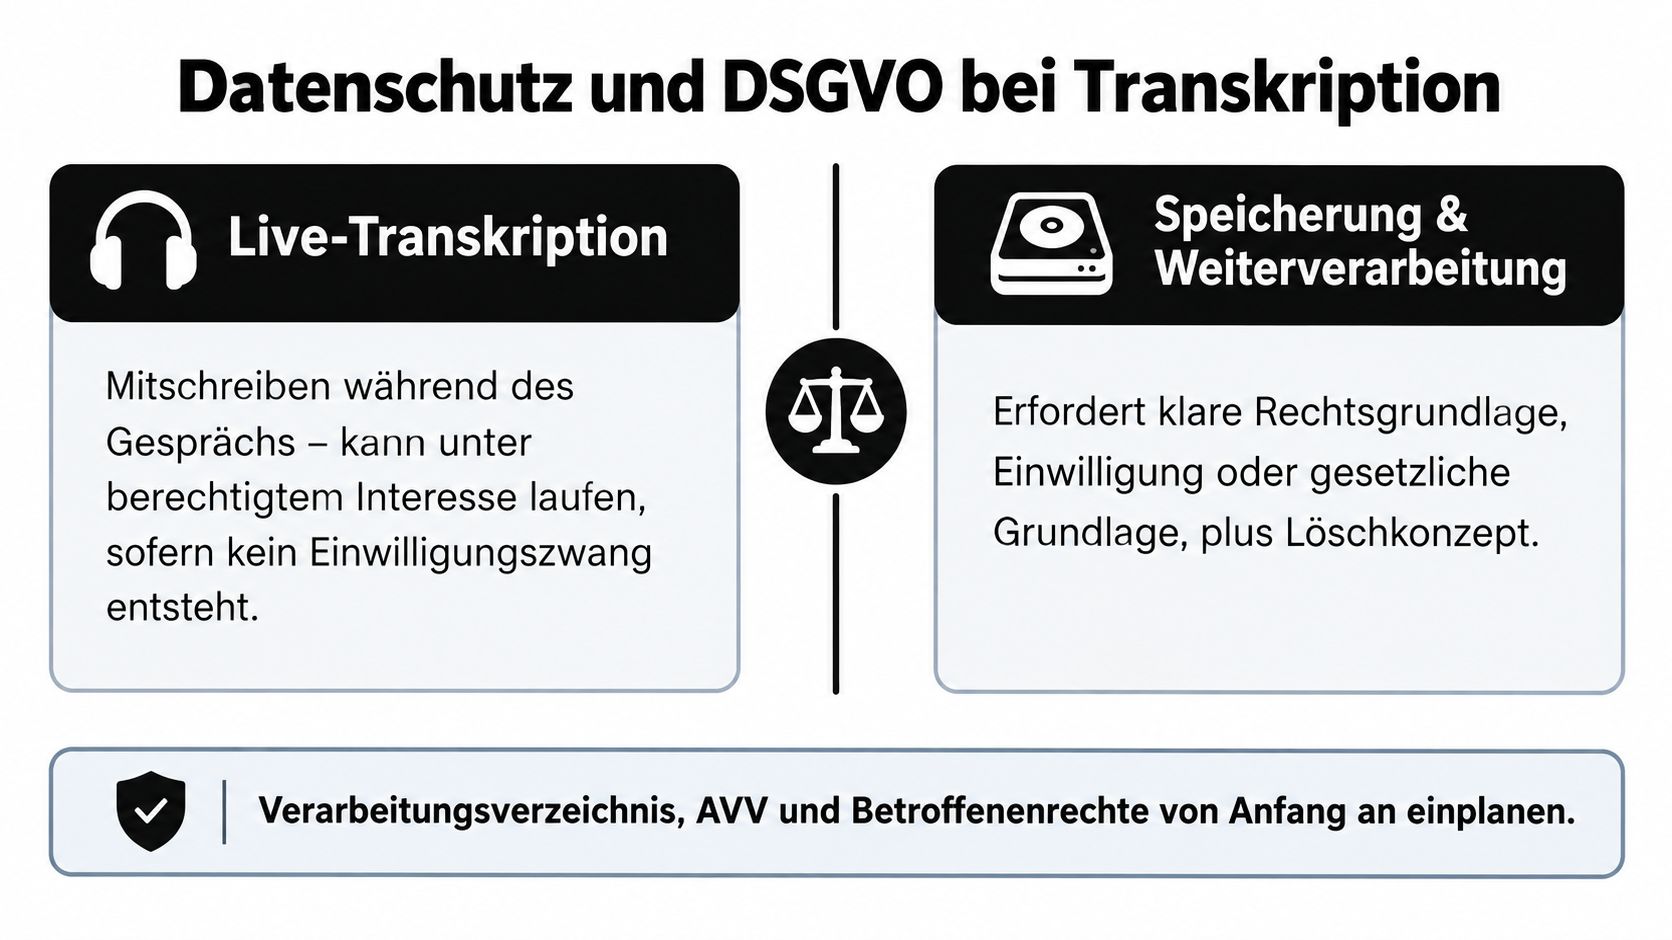
Bei Transkription liegt der wichtigste rechtliche Unterschied zwischen kurzfristigem Mitschreiben und dauerhafter Speicherung. Eine deutsche Einordnung unterscheidet ausdrücklich zwischen Live-Transkription „on the fly“ und der Speicherung des vollständigen Gesprächs oder Transkripts. Live-Verarbeitung kann unter engen Bedingungen eher auf berechtigtes Interesse gestützt werden, während dauerhafte Speicherung in der Regel eine Einwilligung erfordert. Die Einordnung zu Datenschutz und KI-gestützter Transkription sollte dabei nicht als Ersatz für eine individuelle rechtliche Prüfung verstanden werden.
Live ist nicht automatisch erlaubt
Bei einer Live-Transkription wird Sprache während des Gesprächs in Text umgewandelt. Wenn der Text nicht dauerhaft gespeichert und nicht für andere Zwecke weiterverarbeitet wird, kann eine Interessenabwägung möglich sein. Das hängt jedoch vom konkreten Zweck, den Erwartungen der betroffenen Personen und der eingesetzten Technik ab.
Sobald Gesprächsmitschnitte oder vollständige Transkripte archiviert, analysiert oder für Training und Qualitätssicherung verwendet werden, verändert sich die Bewertung. Dann müssen Unternehmen Zweck, Rechtsgrundlage, Zugriff, Löschfrist und Information der Betroffenen nachvollziehbar dokumentieren. Ein allgemeines „Die KI schreibt nur mit“ reicht dafür nicht.
Welche Daten landen im Text
Der Text kann weit mehr enthalten als die eigentliche Gesprächsabsicht:
- Kontaktdaten: Namen, Telefonnummern, E-Mail-Adressen und Anschriften.
- Vertragsinformationen: Preise, Fristen, Auftragsdetails und interne Vereinbarungen.
- Gesundheitsdaten: Symptome, Diagnosen oder Behandlungsinformationen.
- Authentifizierungsdaten: Passwörter, Zugangscodes oder andere Sicherheitsangaben.
- Geschäftsgeheimnisse: Kundendaten, Kalkulationen und vertrauliche Projektinhalte.
Der Leitfaden zur Datenschutzerklärung kann bei der strukturierten Dokumentation helfen. Für die Auswahl eines Dienstleisters sollten außerdem Auftragsverarbeitung, Verschlüsselung, Löschkonzept, Rollenrechte und Hostingstandort geprüft werden. Hinweise zum Umgang mit Datenschutz bei vermittelten Kontakten bietet auch die Ressource Datenschutz bei Anbietervermittlung.
Sensible Spracheingaben vermeiden
Laut TÜV/Bitkom nutzen 38 % die Diktierfunktion, 33 % führen echte Sprachdialoge und insgesamt 50 % mindestens eine Form der Spracheingabe. Diese Werte sind in der Auswertung zur KI-Nutzung im Alltag dokumentiert. Gleichzeitig haben 13 % der KI-Nutzenden bereits persönliche Daten wie Passwörter oder Gesundheitsinformationen eingegeben. Für Unternehmen folgt daraus eine klare Priorität: Privacy-by-Design, Zero-Data-Retention und ein nachvollziehbares Hostingkonzept gehören in die Beschaffung, nicht erst in die Nachprüfung.
Audio-zu-Text im malma-Workflow
Ein Transkript entfaltet seinen Nutzen besonders dann, wenn es nicht in einem isolierten Dashboard endet. Im malma-Workflow wird ein eingehender Anruf direkt mit der Transkriptionspipeline verbunden. Erkannte Inhalte können für die Lead-Qualifizierung strukturiert werden, während besprochene Termine mit dem Kalender des Serviceteams synchronisiert werden.
Dabei lassen sich mehrere Arbeitsschritte in einem Ablauf verbinden. Ein Gespräch kann gleichzeitig ein Transkript erzeugen, einen Lead-Score aktualisieren, einen Kalendereintrag anlegen und ein Ticket auslösen. Das reduziert den manuellen Wechsel zwischen Telefonanlage, Notizen, CRM und Kalender.
CRM und Kalender als gemeinsame Prozessschicht
Die HubSpot-Anbindung kann Kontakte mit Gesprächsthemen, Intent-Scores und nächsten Schritten aktualisieren. Calendly-Termine können über einen Webhook in denselben Ablauf gelangen. Für Teams bedeutet das: Die Stimme des Anrufers wird nicht nur in Text umgewandelt, sondern in strukturierte Informationen überführt, die ein bestehender Prozess weiterverarbeiten kann.
Das ist für Dienstleister und Handwerksbetriebe praktisch, wenn Anfragen außerhalb der Bürozeiten eingehen. Ein Anrufer nennt sein Anliegen, beantwortet Qualifizierungsfragen und vereinbart einen passenden Termin. Die zuständige Person erhält anschließend nicht nur eine Audiodatei, sondern einen nachvollziehbaren Vorgang mit Kontext.
Webhooks für eigene Systeme
Nicht jedes Unternehmen arbeitet mit HubSpot oder Calendly. Über Webhooks können Transkriptions- und Gesprächsdaten auch an eigene Anwendungen, Ticketing-Systeme oder Automatisierungsplattformen weitergegeben werden. Die technischen Möglichkeiten und Datenfelder sollten vor dem Pilotprojekt anhand der malma-API-Dokumentation geprüft werden.
Entscheidend bleibt die Datenminimierung. Übertragen Sie an nachgelagerte Systeme nur die Felder, die der jeweilige Prozess braucht. Ein Terminworkflow benötigt möglicherweise Datum, Uhrzeit, Kontakt und Anliegen, aber nicht den vollständigen Gesprächsverlauf.
Auswahlkriterien und nächste Schritte
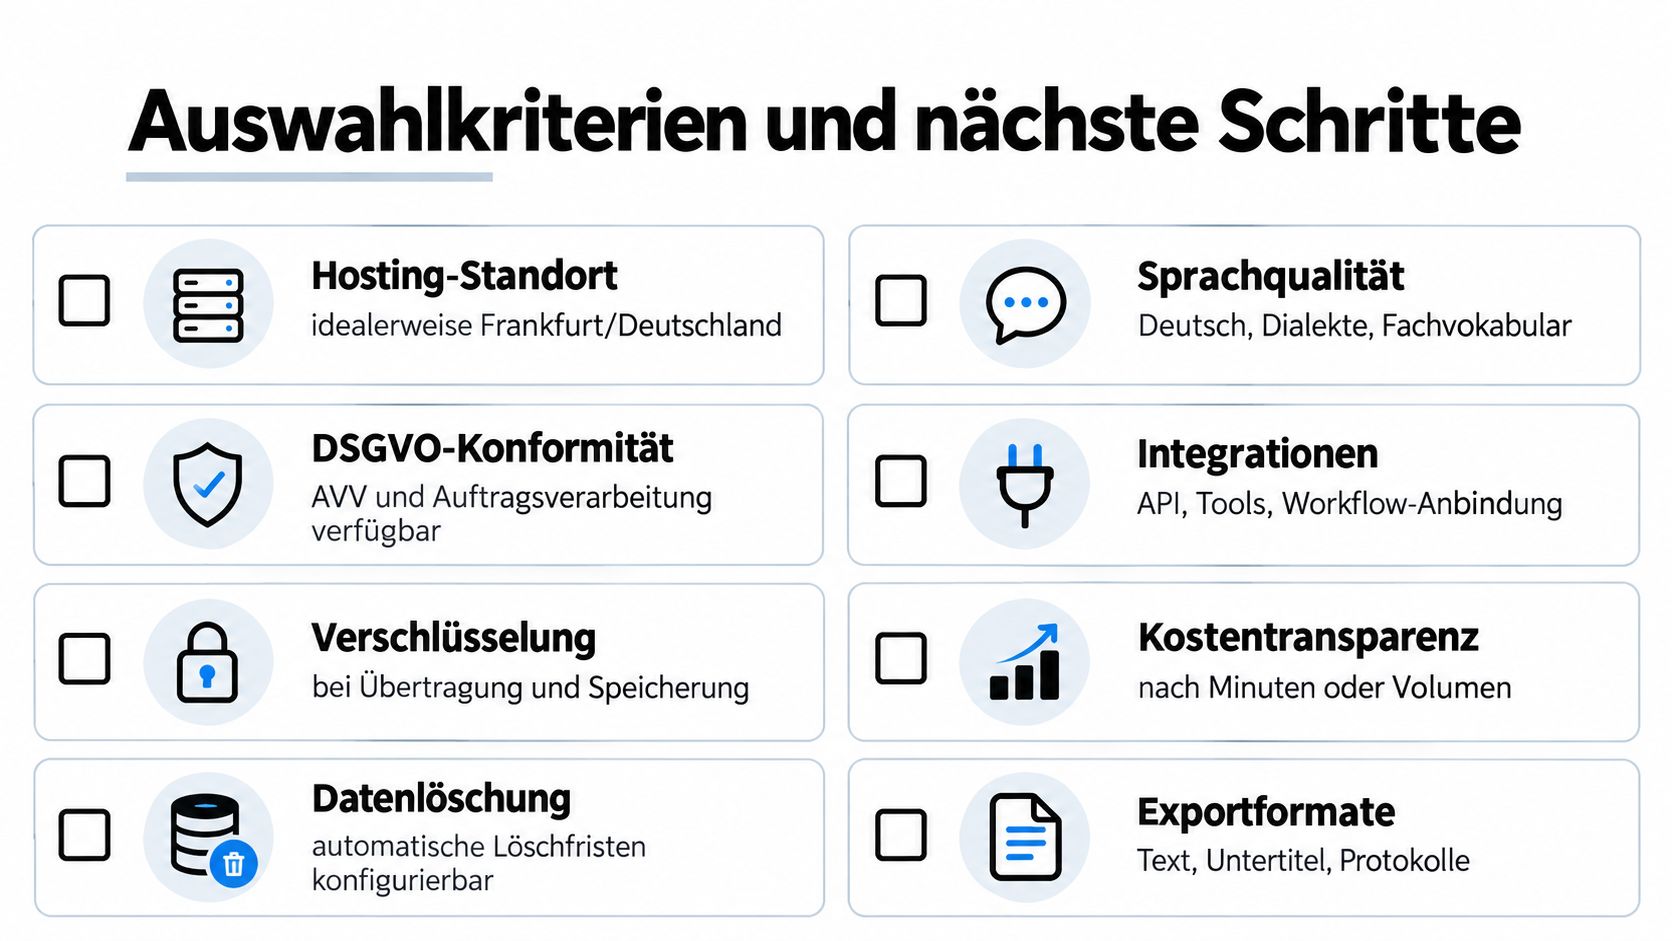
Eine gute Auswahl beginnt nicht mit dem bekanntesten Modell, sondern mit den Anforderungen des eigenen Betriebs. Die folgende Checkliste bündelt die wichtigsten Prüfungen:
- Hostingstandort: Prüfen Sie, ob die Verarbeitung in Frankfurt oder einer anderen deutschen beziehungsweise europäischen Umgebung erfolgt. Für eine Kanzlei ist dieser Punkt meist besonders relevant.
- DSGVO und AVV: Verlangen Sie einen passenden Vertrag zur Auftragsverarbeitung und klare Angaben zu Unterauftragnehmern.
- Erkennungsgenauigkeit: Messen Sie WER und CER mit eigenen, anonymisierten Sprachproben. Ein Handwerksbetrieb sollte Fachbegriffe und Telefonqualität testen.
- Latenz: Für Live-Anrufe zählt die Verzögerung stärker als bei nachträglichen Meeting-Protokollen.
- Modellwahl: Vergleichen Sie Cloud und On-Premise anhand von Datenschutz, Volumen und vorhandener Infrastruktur.
- Integrationen: Prüfen Sie CRM, Kalender, Webhooks und Exportformate. Eine Arztpraxis braucht andere Übergaben als eine Agentur.
- Preismodell: Lassen Sie sich Kosten pro Audiominute, Mindestvolumen und Zusatzgebühren nachvollziehbar ausweisen.
- Exit-Option: Klären Sie, wie Transkripte, Metadaten und Konfigurationen bei einem Anbieterwechsel exportiert und gelöscht werden.
Vom Vergleich zum belastbaren Pilotprojekt
Starten Sie mit 60 Minuten eigenem Audiomaterial, das typische Gesprächssituationen abbildet. Prüfen Sie danach in einem 14-tägigen Pilotprojekt reale Live-Anrufe, dokumentieren Sie Fehler und bewerten Sie, ob die Folgeaktionen zuverlässig ausgelöst werden.
Halten Sie die Ergebnisse in einer Vergleichsmatrix fest. So sehen Sie nicht nur, welches Modell gut transkribiert, sondern auch, welcher Anbieter rechtlich, technisch und organisatorisch zu Kanzlei, Handwerksbetrieb, Arztpraxis oder Agentur passt.
malma.ai verbindet KI-Telefonie mit Audio-zu-Text, Lead-Qualifizierung, Kalender-Synchronisation und CRM-Workflows, damit aus Gesprächen strukturierte Vorgänge entstehen. Prüfen Sie die verfügbaren Integrationen und starten Sie Ihren eigenen Anwendungsfall direkt auf malma.ai.