Redundante Systeme: Hochverfügbarkeit 2026 meistern
Erfahren Sie, wie redundante systeme Ausfallzeiten minimieren. Details zu Architektur, Voice-AI, Checklisten, Kosten & DSGVO-Hinweise für 2026.
Montagmorgen, die ersten Interessenten rufen an, und Ihr Vertrieb wartet auf qualifizierte Leads. Dann fällt der zentrale Server aus. Kurz darauf verliert ein Hardwaredefekt den Zugriff auf die Telefonie, während ein Stromproblem die Anwendung zusätzlich ausbremst. Für ein kleines oder mittleres Unternehmen bedeutet das nicht nur eine technische Störung, sondern verpasste Gespräche, unterbrochene Terminbuchungen und eine Pipeline, die plötzlich stillsteht.
Genau hier beginnen redundante Systeme. Sie sorgen dafür, dass eine einzelne defekte Komponente nicht automatisch den gesamten Geschäftsprozess beendet. Besonders bei Voice-AI-Plattformen muss die Absicherung mehrere Ebenen umfassen, von der Datenhaltung über Sprach- und Telefoniekomponenten bis zu Kalendern, CRM-Schnittstellen, Stromversorgung und Netzwerkwegen.
Einführung in redundante Systeme
Ein mittelständischer Dienstleister nutzt eine automatisierte Telefonanlage zur Lead-Qualifizierung. Die Voice-AI nimmt Anrufe an, stellt Fragen, bewertet Gesprächsinformationen und bucht passende Termine. Als der primäre Rechner ausfällt, startet das Ersatzsystem jedoch nicht. Die Konfiguration liegt nur lokal vor. Anrufe bleiben unbeantwortet, neue Kontakte erreichen das CRM nicht.
Der Fehler steckt selten in einer einzelnen spektakulären Störung. Häufig treffen Hardwaredefekt, fehlendes Failover, unvollständige Replikation oder die Abhängigkeit von einem Netzwerk- oder Cloud-Anbieter zusammen. Redundanz bedeutet deshalb mehr als eine zweite Maschine im Serverraum. Kritische Funktionen werden so verteilt, dass der Ausfall einer Komponente den gesamten Prozess nicht stoppt.
Für deutsche Mittelständler hat das eine direkte wirtschaftliche Bedeutung. Eine Untersuchung aus dem Jahr 2013 meldete, dass 77 Prozent der befragten Unternehmen im Vorjahr Ausfälle geschäftskritischer IT-Systeme erlebt hatten. Im Durchschnitt traten vier Ausfälle je Unternehmen und Jahr auf. Die durchschnittlichen Kosten lagen bei 25.000 Euro pro Ausfallstunde, bei kleineren Unternehmen bei rund 20.000 Euro und bei größeren Firmen bei etwa 40.000 Euro je Stunde. Die Werte stehen in der Auswertung zu Ausfallsicherheit und Kosten im deutschen Mittelstand.
Praktische Regel: Der wirtschaftliche Wert eines redundanten Systems beginnt mit der Frage, welche Geschäftsprozesse eine Ausfallstunde nicht verkraften.
Bei einer Voice-AI-Plattform reicht es nicht, einen erreichbaren Server zu haben. Ein Anruf muss angenommen, das Gespräch verarbeitet, ein Termin synchronisiert und der Datensatz korrekt an das CRM übergeben werden. malma.ai zeigt damit die relevante Perspektive: Absicherung betrifft die gesamte Prozesskette und schützt Reaktionsgeschwindigkeit, Umsatzchancen und Kundenvertrauen.
Kernkonzept von Redundanz verstehen
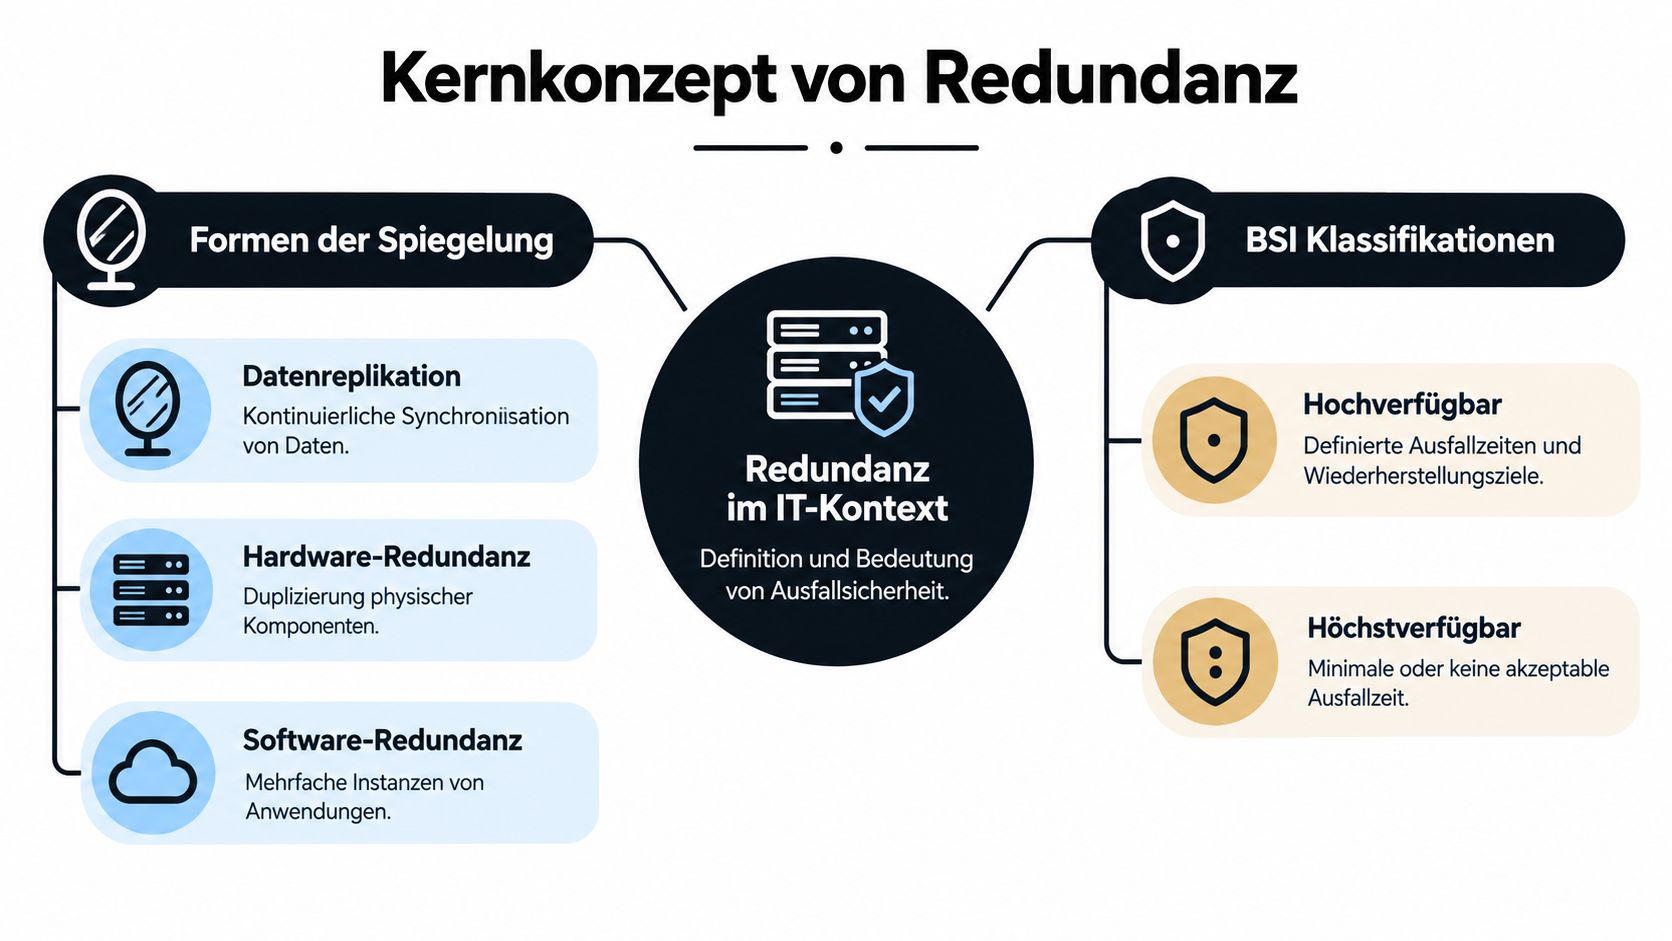
Redundanz bezeichnet die zusätzliche Auslegung von Komponenten, Datenwegen oder Systeminstanzen, damit eine Funktion trotz eines Teilausfalls verfügbar bleibt. Das BSI beschreibt den einfachsten Fall als ein zweites, identisches System, das bei einem Ausfall die Aufgaben des ersten übernimmt. Bei georedundanten Systemen müssen die Standorte so weit voneinander entfernt sein, dass ein großräumiges Ereignis höchstens eines der Systeme trifft, wie die BSI-Dokumentation zu Verfügbarkeitsanforderungen zusammenfasst.
Eine verständliche Analogie ist ein Backup-Generator in einem Kraftwerk. Die Reserve hilft aber nur, wenn sie angeschlossen, betriebsbereit und ausreichend dimensioniert ist. Bei IT-Systemen gilt dasselbe: Ein Ersatzserver ohne aktuelle Daten, ohne Netzwerkzugang oder ohne getestete Umschaltlogik ist keine belastbare Redundanz.
Drei Ebenen der Spiegelung
Datenreplikation hält Informationen auf mehreren Systemen verfügbar. Das kann synchron erfolgen, wenn Änderungen unmittelbar auf die zweite Instanz übertragen werden, oder asynchron, wenn die Übertragung zeitversetzt läuft. Für Voice-AI-Anwendungen betrifft das etwa Agentenkonfigurationen, Gesprächsdaten, Terminstatus und Integrationsdaten.
Hardware-Redundanz dupliziert physische Bauteile. Dazu zählen Server, Speichersysteme, Netzteile, Netzwerkgeräte und Versorgungswege. Ein System kann trotzdem ausfallen, wenn beide Server am selben Stromkreis oder hinter demselben Netzwerkgerät hängen.
Software-Redundanz startet mehrere unabhängige Anwendungsinstanzen. Ein Load Balancer verteilt Anfragen, während ein Orchestrator fehlerhafte Instanzen erkennt und den Betrieb auf gesunde Einheiten verlagert.
Verfügbarkeit richtig einordnen
Ein einzelnes, nicht speziell hochverfügbares Serversystem erreicht typischerweise etwa 99,5 Prozent Verfügbarkeit, was rechnerisch mehr als 40 Stunden jährliche Ausfallzeit bedeutet. Cluster-Systeme mit 99,95 bis 99,99 Prozent können die Ausfallzeit auf bis zu rund eine Stunde im Jahr senken, wie die zuvor genannte BSI-Zusammenfassung erläutert.
Das BSI unterscheidet für Rechenzentren mit erhöhtem Verfügbarkeitsbedarf zwischen hochverfügbar und höchstverfügbar. Hochverfügbar bedeutet 99,99 Prozent pro Jahr, also rund eine Stunde Ausfallzeit. Höchstverfügbar entspricht 99,999 Prozent, also ungefähr fünf Minuten, gemäß der BSI-Veröffentlichung zur Verfügbarkeit von Rechenzentren.
Für diese Zielgrößen reicht eine doppelte Anwendung nicht aus. Das BSI fordert bei Energie- und Kälteversorgung mindestens N+1-Redundanz. Das bedeutet: Die benötigte Anzahl an Komponenten ist vorhanden, zusätzlich gibt es mindestens eine Reserve. Fällt eine Einheit aus, bleibt die erforderliche Kapazität erhalten.
Vergleich gängiger Redundanzmuster
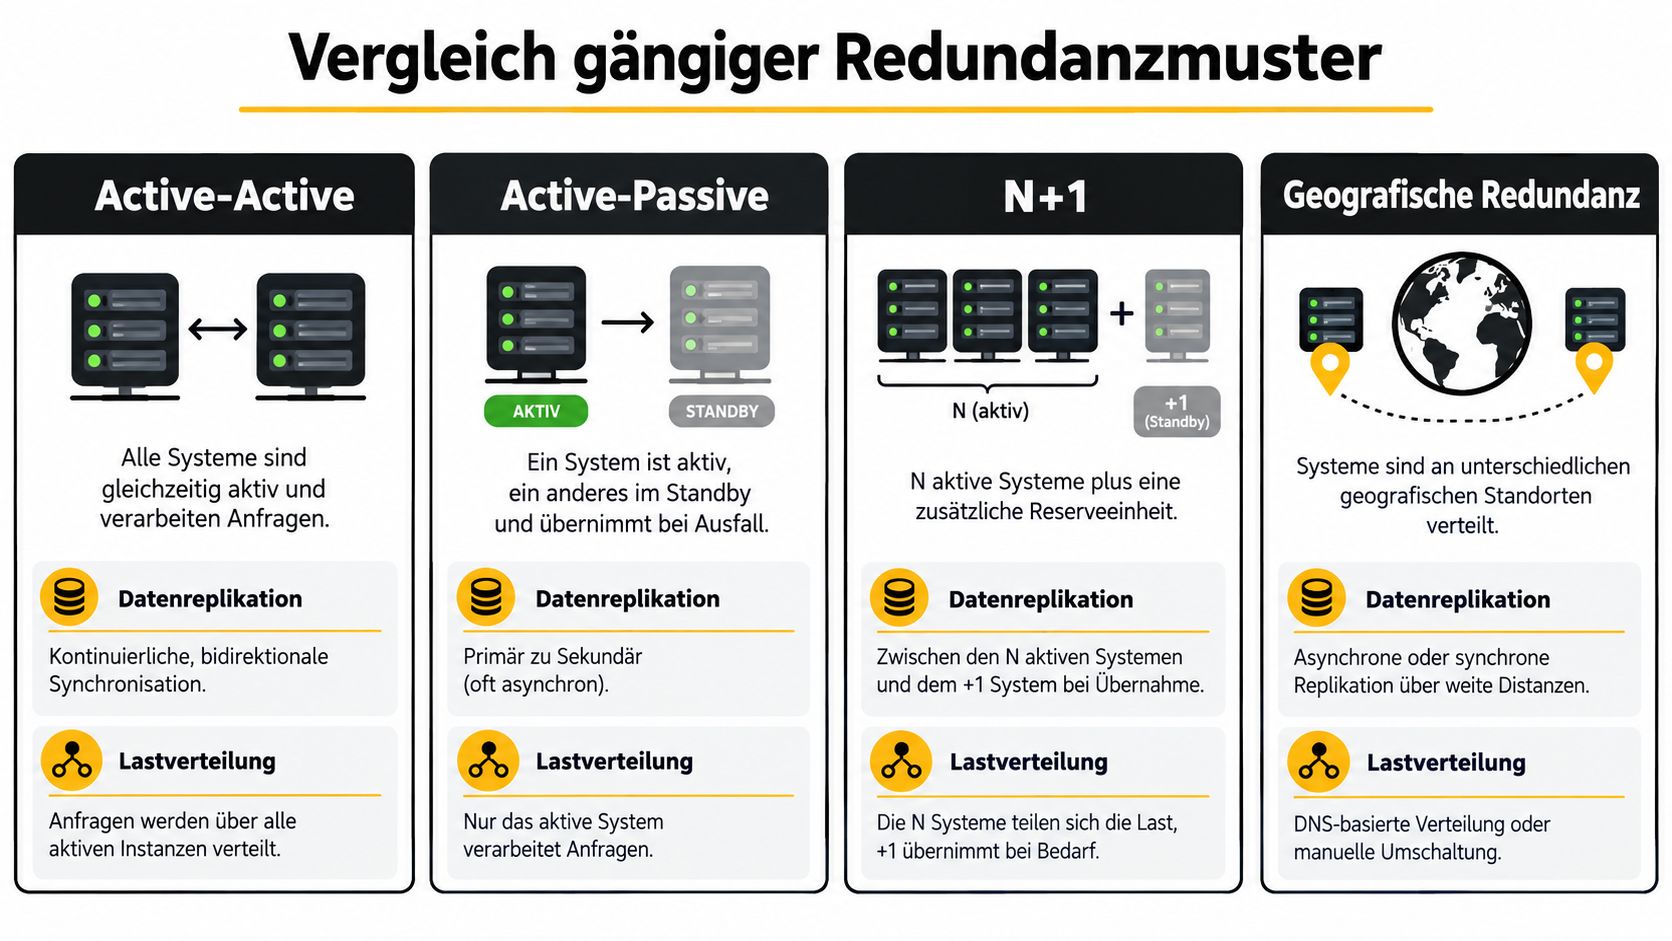
Die passende Architektur hängt vom Ausfallszenario, der zulässigen Umschaltzeit, der Datenkonsistenz und dem verfügbaren Budget ab. Active-Active schützt anders als Active-Passive, während N+1 vor allem die Reservekapazität beschreibt. Geografische Redundanz ergänzt diese Muster um die räumliche Trennung.
Active-Active
Bei Active-Active arbeiten mehrere Instanzen gleichzeitig. Ein Load Balancer verteilt eingehende Anfragen, während die Systeme ihre Daten kontinuierlich und häufig bidirektional synchronisieren. Fällt eine Instanz aus, können die übrigen den Betrieb direkt weiterführen.
Das Muster eignet sich für Voice-AI-Plattformen mit wechselnder Gesprächslast und hohen Anforderungen an die Reaktionszeit. Der Nachteil liegt in der Komplexität. Konflikte bei Gesprächszuständen, Kalenderbuchungen oder CRM-Updates müssen sauber gelöst werden. Auch die Datenreplikation über größere Entfernungen kann zusätzliche Latenz verursachen.
Active-Passive
Bei Active-Passive verarbeitet eine primäre Instanz den Betrieb. Die sekundäre Instanz bleibt im Standby und übernimmt erst nach einer erkannten Störung. Die Replikation läuft häufig vom Primär- zum Sekundärsystem und kann asynchron erfolgen.
Dieses Muster ist leichter zu kontrollieren und kann für kleinere Umgebungen wirtschaftlicher sein. Dafür muss die Umschaltung funktionieren, und die Standby-Instanz darf nicht veraltet oder falsch konfiguriert sein. Bei einer Voice-AI-Anwendung sollten insbesondere Rufnummern, Agentenlogik, Integrationen und Gesprächszustände im Failover berücksichtigt werden.
N+1
N+1 beschreibt eine zusätzliche Reserveeinheit neben den tatsächlich benötigten aktiven Komponenten. Mehrere Server teilen sich die Last, die zusätzliche Einheit übernimmt bei Bedarf. Das Muster ist besonders nützlich bei Energie- und Kälteversorgung sowie bei Infrastrukturkomponenten, bei denen die Reserve nicht dauerhaft Anfragen bearbeiten muss.
N+1 schützt jedoch nicht automatisch gegen einen Standortausfall. Wenn alle Einheiten im gleichen Gebäude stehen und dieselbe Strom- oder Netzwerkinfrastruktur nutzen, bleibt ein gemeinsamer Fehlerpfad bestehen.
Geografische Redundanz
Geografische Redundanz verteilt Systeme auf unabhängige Standorte. Das BSI fordert für gegenseitig redundante Rechenzentren einen Mindestabstand von 200 Kilometern, damit regionale Störungen nicht beide Standorte treffen, wie die BSI-Kriterien für Rechenzentrumsstandorte festlegen.
Die Replikation kann synchron oder asynchron erfolgen. Die Umschaltung läuft beispielsweise über Routing, einen zentralen Vermittlungsdienst oder eine kontrollierte manuelle Aktivierung. Der Vorteil ist der Schutz vor regionalen Ereignissen. Die Nachteile sind höhere Anforderungen an Netzwerk, Betrieb, Datenabgleich und Notfallorganisation.
Architekturbeispiele für Voice-AI Plattformen
Bei einer Voice-AI-Plattform besteht der kritische Prozess aus mehreren Stationen. Der Anruf muss den Telefonie-Einstieg erreichen, eine Sprach- und Dialoginstanz muss verfügbar sein, der Gesprächszustand muss gespeichert werden, und nach dem Gespräch müssen Kalender und CRM korrekt aktualisiert werden. Eine Architektur, die nur den Anwendungsserver doppelt, lässt die übrigen Abhängigkeiten ungeschützt.
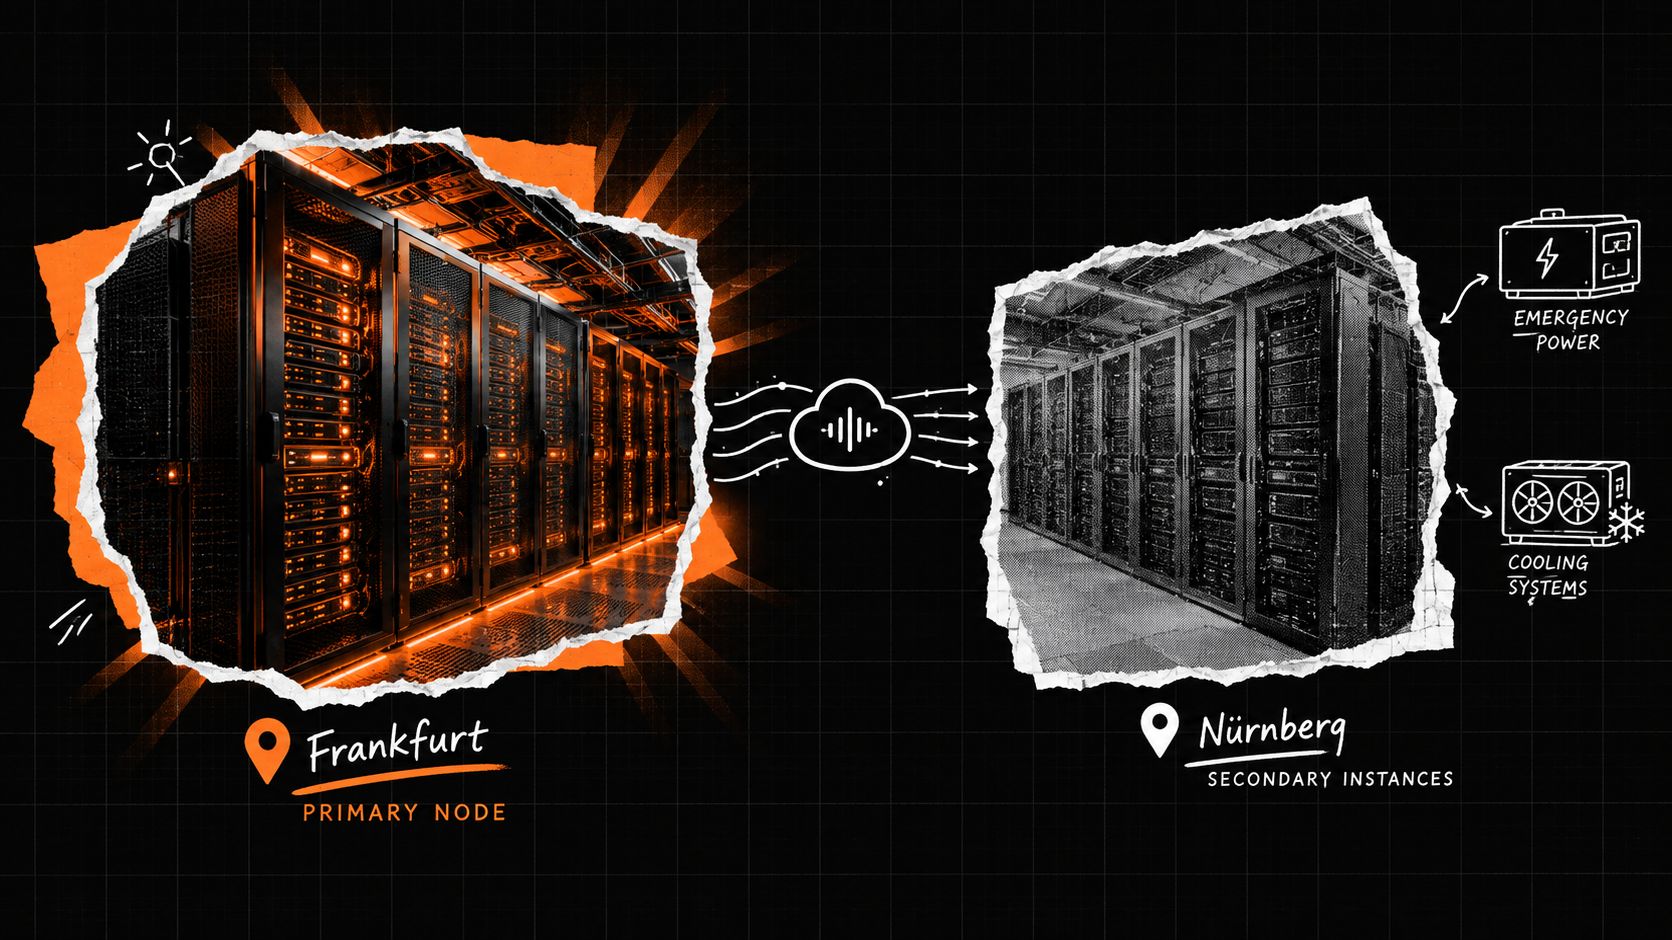
Ein praxisnahes Modell für malma.ai verteilt die primären Verteilungsknoten in Frankfurt und sekundäre Anwendungsinstanzen in Nürnberg. Die räumliche Trennung folgt dem Grundgedanken georedundanter Planung. Für das Beispiel sind nicht nur die Server relevant, sondern auch getrennte Energie- und Kühlkreisläufe, unabhängige Netzwerkpfade und eine definierte Failover-Logik.
Was bei der Plattform gespiegelt werden muss
Die Sprach- und Dialog-Engines sollten auf mehreren Instanzen verfügbar sein. Bei einem Fehler übernimmt eine gesunde Instanz die Verarbeitung. Dabei muss die Plattform definieren, wie ein laufendes Gespräch behandelt wird. Ein neuer Anruf kann meist einfacher umgeschaltet werden als eine bereits aktive Sitzung.
Der Kalender-Sync braucht eine klare Wiederholungslogik. Wenn ein Termin gebucht wurde, darf ein erneuter Übertragungsversuch nicht versehentlich einen zweiten Termin erzeugen. Für CRM-Integrationen gilt dasselbe. Jede Übergabe sollte nachvollziehbar protokolliert werden, damit ein Failover keine doppelten oder fehlenden Datensätze erzeugt.
Auch die Telefonieanbindung gehört in die Ausfallsicherheitsplanung. Ein zweiter SIP-Provider, alternatives Routing und ein separates Backup der Agentenkonfiguration sind typische Fallback-Maßnahmen, wie der Beitrag zur SIP-Trunking-Erklärung erläutert.
Der BSI-Lagebericht 2025 hebt die Bedeutung von Resilienz und Redundanz angesichts von Cloud- und Netzwerkstörungen hervor. 46 Prozent der deutschen Unternehmen berichten mindestens wöchentlich von solchen Störungen, wie der BSI-Lagebericht 2025 angibt.
Für ein KMU lautet die entscheidende Frage daher nicht nur, ob ein zweiter Server existiert. Entscheidend ist, ob ein Anruf trotz gestörter Region, Telefonie, Anwendung oder Integration sinnvoll weiterbearbeitet werden kann.
Implementierung und Checkliste
Eine redundante Architektur entsteht nicht durch den Kauf eines Ersatzservers. Sie beginnt mit einer dokumentierten Entscheidung darüber, welche Geschäftsprozesse geschützt werden müssen und welche Unterbrechung das Unternehmen akzeptiert.
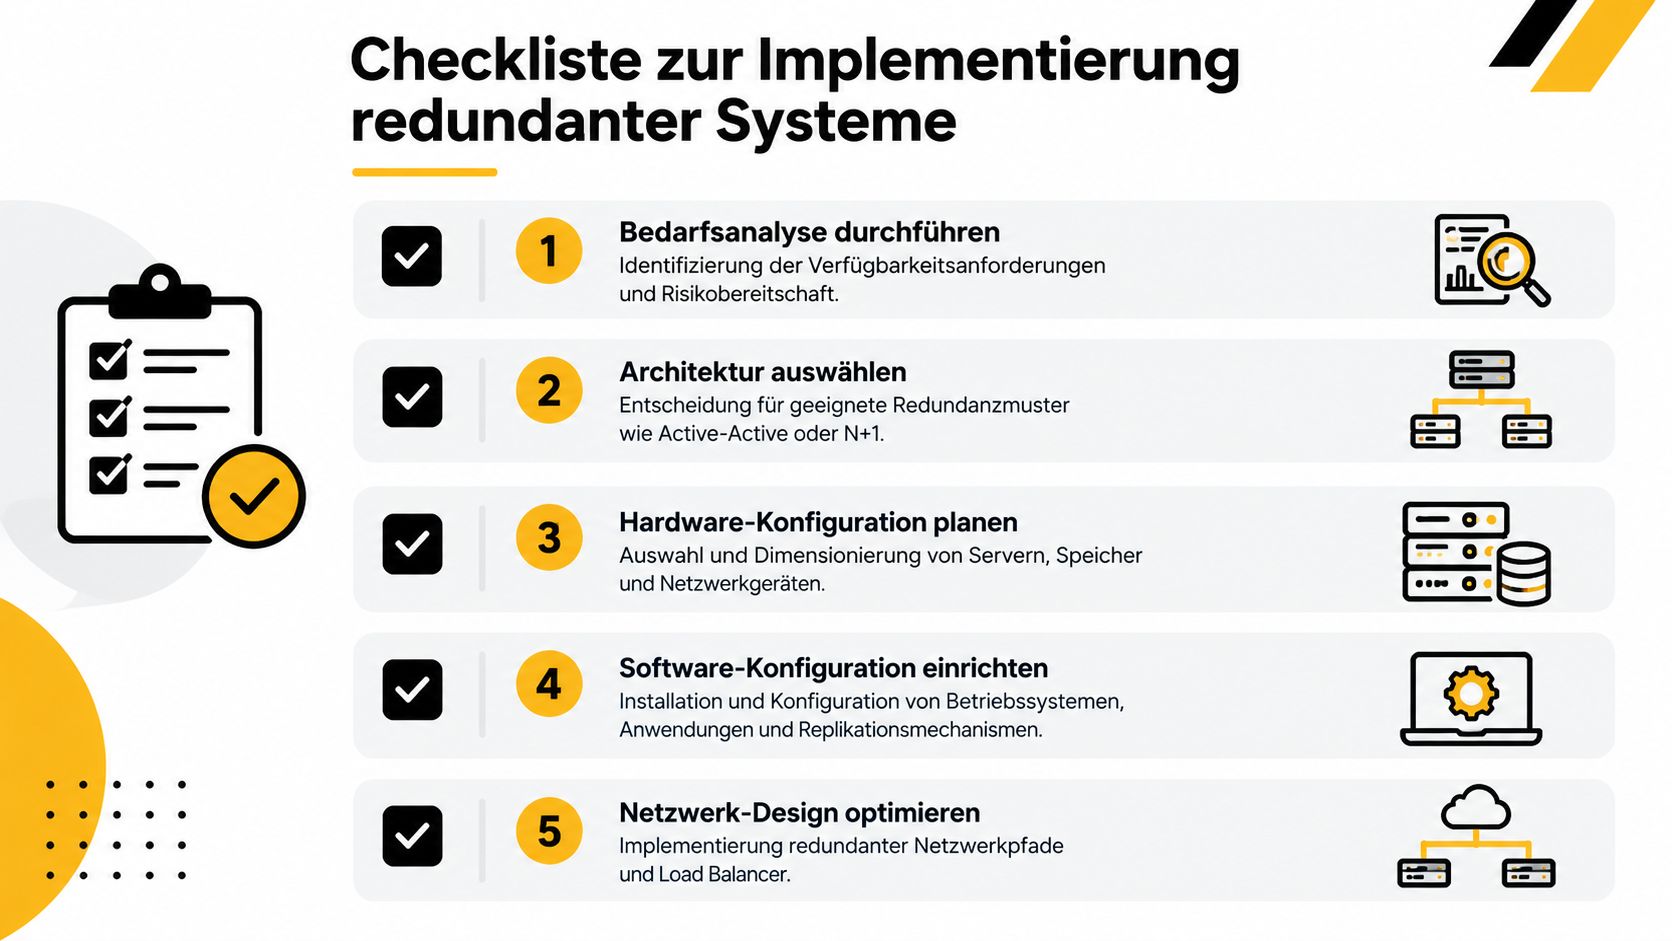
Die praktische Reihenfolge
Bedarf analysieren: Erfassen Sie kritische Anwendungen, Daten, Telefoniepfade und Integrationen. Dokumentieren Sie, wann ein Ausfall den Vertrieb, Kundenservice oder Betrieb unmittelbar beeinträchtigt.
Architektur auswählen: Entscheiden Sie je Prozess zwischen Active-Active, Active-Passive, N+1 und geografischer Redundanz. Eine Voice-AI-Plattform kann beispielsweise aktive Anwendungsknoten und einen passiven Notfallpfad kombinieren.
Hardware dimensionieren: Planen Sie Server, Speicher, Netzwerkgeräte, Stromversorgung und Kühlung gemeinsam. Prüfen Sie, ob zwei Systeme tatsächlich voneinander unabhängige Versorgungswege besitzen.
Software konfigurieren: Richten Sie Replikation, Zustandsverwaltung, Monitoring, Wiederholungslogik und Failover ein. Halten Sie Agentenkonfigurationen, Routingregeln und Integrationsdaten versioniert und wiederherstellbar.
Netzwerk entkoppeln: Nutzen Sie redundante Pfade und geeignete Load-Balancing-Mechanismen. Testen Sie, ob der Ausfall eines einzelnen Netzwerkknotens, Providers oder Standorts den Datenfluss unterbricht.
Betriebsregel: Jede automatische Umschaltung braucht einen definierten Rückweg. Dokumentieren Sie deshalb nicht nur das Failover, sondern auch Rollback, Zustandsprüfung und Freigabe zur Rückkehr in den Normalbetrieb.
Monitoring und Ausfalltests durchführen
Ein redundantes System kann monatelang unbemerkt in einem geschwächten Zustand laufen. Wenn die Reserve nicht erreichbar ist, die Replikation stockt oder ein Zertifikat abläuft, bemerkt das Team den Fehler möglicherweise erst beim nächsten Ausfall. Monitoring muss deshalb die Redundanz selbst überwachen, nicht nur den aktiven Dienst.
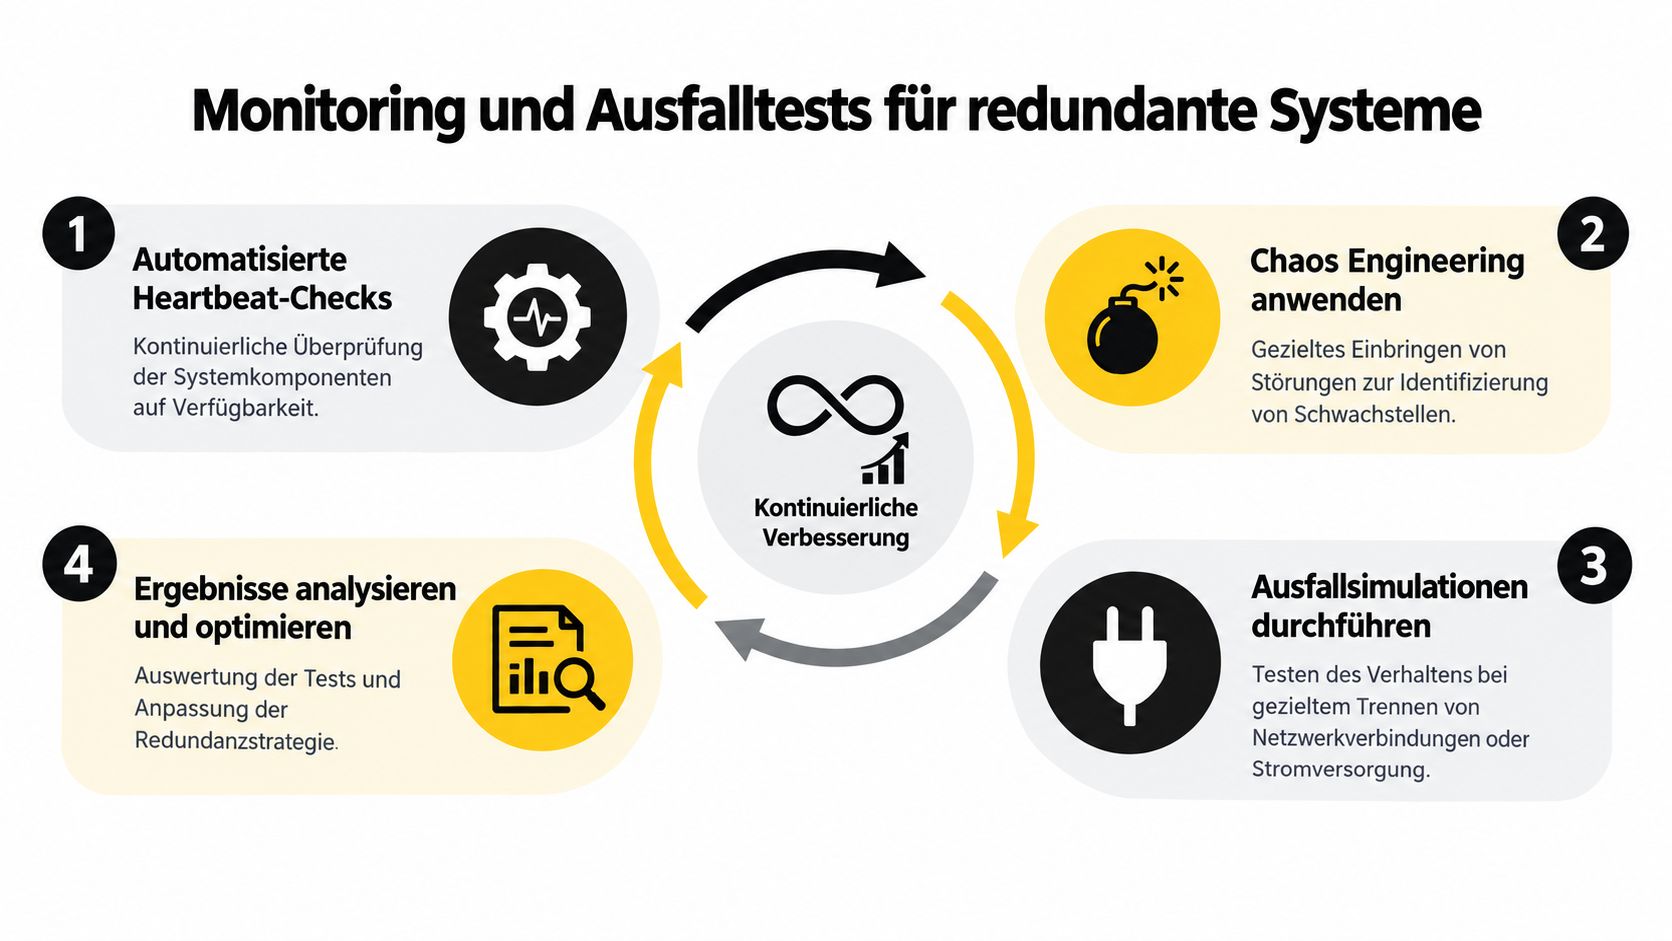
Ein belastbarer Testzyklus
Heartbeat-Checks prüfen regelmäßig, ob Server, Datenbanken, Telefoniepfade und Integrationen antworten. Ein einfacher Erreichbarkeitstest reicht nicht. Die Prüfung sollte auch Replikationsstatus, Datenalter, Fehlerraten und die Fähigkeit zur Übernahme erfassen.
Anschließend simuliert das Betriebsteam kontrollierte Störungen. Dazu gehören das Trennen eines Netzwerkpfads, das Deaktivieren einer Anwendungseinheit oder das Umschalten eines Telefonieproviders. Bei Voice-AI-Systemen sollte der Test prüfen, ob ein neuer Anruf angenommen, ein Termin korrekt verarbeitet und der CRM-Eintrag vollständig geschrieben wird.
Der Beitrag zur Ausfallsicherheit von malma.ai beschreibt für Voice-AI unter anderem SIP-Redundanz, Fallback-Routing und Failover. Diese Mechanismen müssen in der eigenen Umgebung praktisch validiert werden, nicht nur in einer Architekturzeichnung.
Metriken und menschliche Fehler
Beobachten Sie während eines Tests die Latenz, Fehlerraten, Umschaltzeit, Gesprächsabbrüche, Datenkonsistenz und Wiederanlaufzeit. Nach dem Test gehören die Ergebnisse in ein Protokoll, einschließlich festgestellter Abweichungen und konkreter Korrekturmaßnahmen.
Der Uptime-Bericht 2025 weist darauf hin, dass der Anteil von Ausfällen durch menschliche Fehler wegen nicht eingehaltener Verfahren um zehn Prozentpunkte gestiegen ist, wie die deutsche Zusammenfassung des Berichts dokumentiert. Klare Runbooks, Vier-Augen-Prüfungen und regelmäßige Simulationen reduzieren das Risiko, dass ein Bedienfehler die Redundanz außer Kraft setzt.
Kosten Trade-offs und Compliance Hinweise
Redundanz erhöht zunächst die laufenden Kosten. Zusätzliche Infrastruktur, Lizenzen, Netzwerkverbindungen, Speicher, Monitoring, Wartung und Ausfalltests müssen eingeplant werden. Wirtschaftlich trägt sich diese Architektur, wenn ihre Kosten zum möglichen Schaden eines Betriebsunterbruchs passen. Die Mittelstandsanalyse zu IT-Ausfallkosten unterstützt dabei, kritische Prozesse zu priorisieren. Für den eigenen Betrieb ersetzt sie keine individuelle Berechnung.
| Aspekt | Kostenfaktor | Compliance-Anforderung |
|---|---|---|
| Infrastruktur | Zusätzliche Server, Speicher, Strom- und Kühlpfade | Verantwortlichkeiten, Betriebsdokumentation und Nachweise zur Verfügbarkeit |
| Replikation | Software, Bandbreite, Speicherbedarf und Pflege | Nachvollziehbare Datenflüsse, Zugriffskontrollen und Wiederherstellungsprozesse |
| Telefonie und Netzwerk | Zweite Provider, Routing und Überwachung | Dokumentierte Ausweichwege, Datenschutzprüfung und Protokollierung |
| Betrieb | Tests, Wartung, Bereitschaft und Schulung | Regelmäßige Prüfungen, Notfallhandbuch und Änderungsmanagement |
| Voice-AI | Sprachmodelle, Agentenkonfigurationen und Integrationen | DSGVO-konforme Verarbeitung, transparente Zuständigkeiten und risikobasierte EU-AI-Act-Prüfung |
Die Tabelle macht eine typische Fehlannahme sichtbar: Eine Voice-AI-Plattform besteht nicht nur aus Servern. Auch Telefonieanbieter, Sprachmodelle, Agentenkonfigurationen und CRM-Übergaben können eigene Kosten- und Compliance-Risiken erzeugen. Fällt ein Dienst aus, braucht die Ausweichlösung passende Daten, Berechtigungen und dokumentierte Zuständigkeiten.
Bei personenbezogenen Gesprächsdaten sind Zweck, Zugriff, Aufbewahrung und Löschung festzulegen. In die Bewertung gehören außerdem Auftragsverarbeitung, technische Schutzmaßnahmen und die eingesetzten Dienstleister. Der Guide zu Compliance-Herausforderungen bietet dafür eine zusätzliche Orientierung.
Ein SLA sollte Verfügbarkeit, Reaktionszeit, Wiederherstellungsleistung und Eskalation festhalten. Der Leitfaden zum Service-Level-Agreement hilft bei der Einordnung, wenn Telefonie, Hosting und CRM von verschiedenen Anbietern bereitgestellt werden.
Nicht jeder Prozess braucht die höchste Verfügbarkeitsklasse. Ein internes Berichtssystem kann anders priorisiert werden als eine Telefonie, die laufend neue Leads annimmt. Eine abgestufte Architektur schützt das Budget und sichert die Kontaktpunkte ab, deren Ausfall unmittelbar Geschäftsabläufe stört.
Fazit zu redundanten Systemen
Redundante Systeme sind keine reine Vervielfältigung von Hardware. Sie verbinden Datenreplikation, Failover, unabhängige Versorgungswege, geographische Trennung, Monitoring und eingeübte Betriebsprozesse. Für Voice-AI-Plattformen müssen Unternehmen zusätzlich Telefonie, Sprachverarbeitung, Gesprächszustände, Kalender und CRM-Übergaben als zusammenhängenden Prozess betrachten.
Active-Active eignet sich für kontinuierliche Lastverteilung, Active-Passive für kontrollierte Übernahmen, N+1 für Reservekapazität und geografische Redundanz für regionale Störungen. Die richtige Wahl folgt aus Geschäftsrisiko, Wiederanlaufziel, Datenanforderungen und Compliance, nicht aus einem pauschalen Architekturtrend.
Starten Sie mit einer Liste aller Single Points of Failure, ordnen Sie jedem Punkt einen akzeptablen Ausfallwert zu und testen Sie anschließend den geplanten Notfallpfad. So wird Hochverfügbarkeit von einem abstrakten Versprechen zu einer überprüfbaren Betriebseigenschaft.
malma.ai unterstützt Unternehmen bei automatisierter Lead-Qualifizierung, Terminbuchung und eingehender Telefonie mit Voice-AI, Kalender-Synchronisation sowie CRM- und Messenger-Anbindungen. Prüfen Sie auf malma.ai, wie sich eine Voice-AI-Telefonie in Ihre redundante und compliance-orientierte Prozessarchitektur integrieren lässt.